最近我在调整 Claude 的英文输出风格时,反复遇到一个问题 —— 我已经给了它很多抽象规则,比如:
不要说黑话,使用直接平实的语言;不要自行发明术语除非事先给出定义。
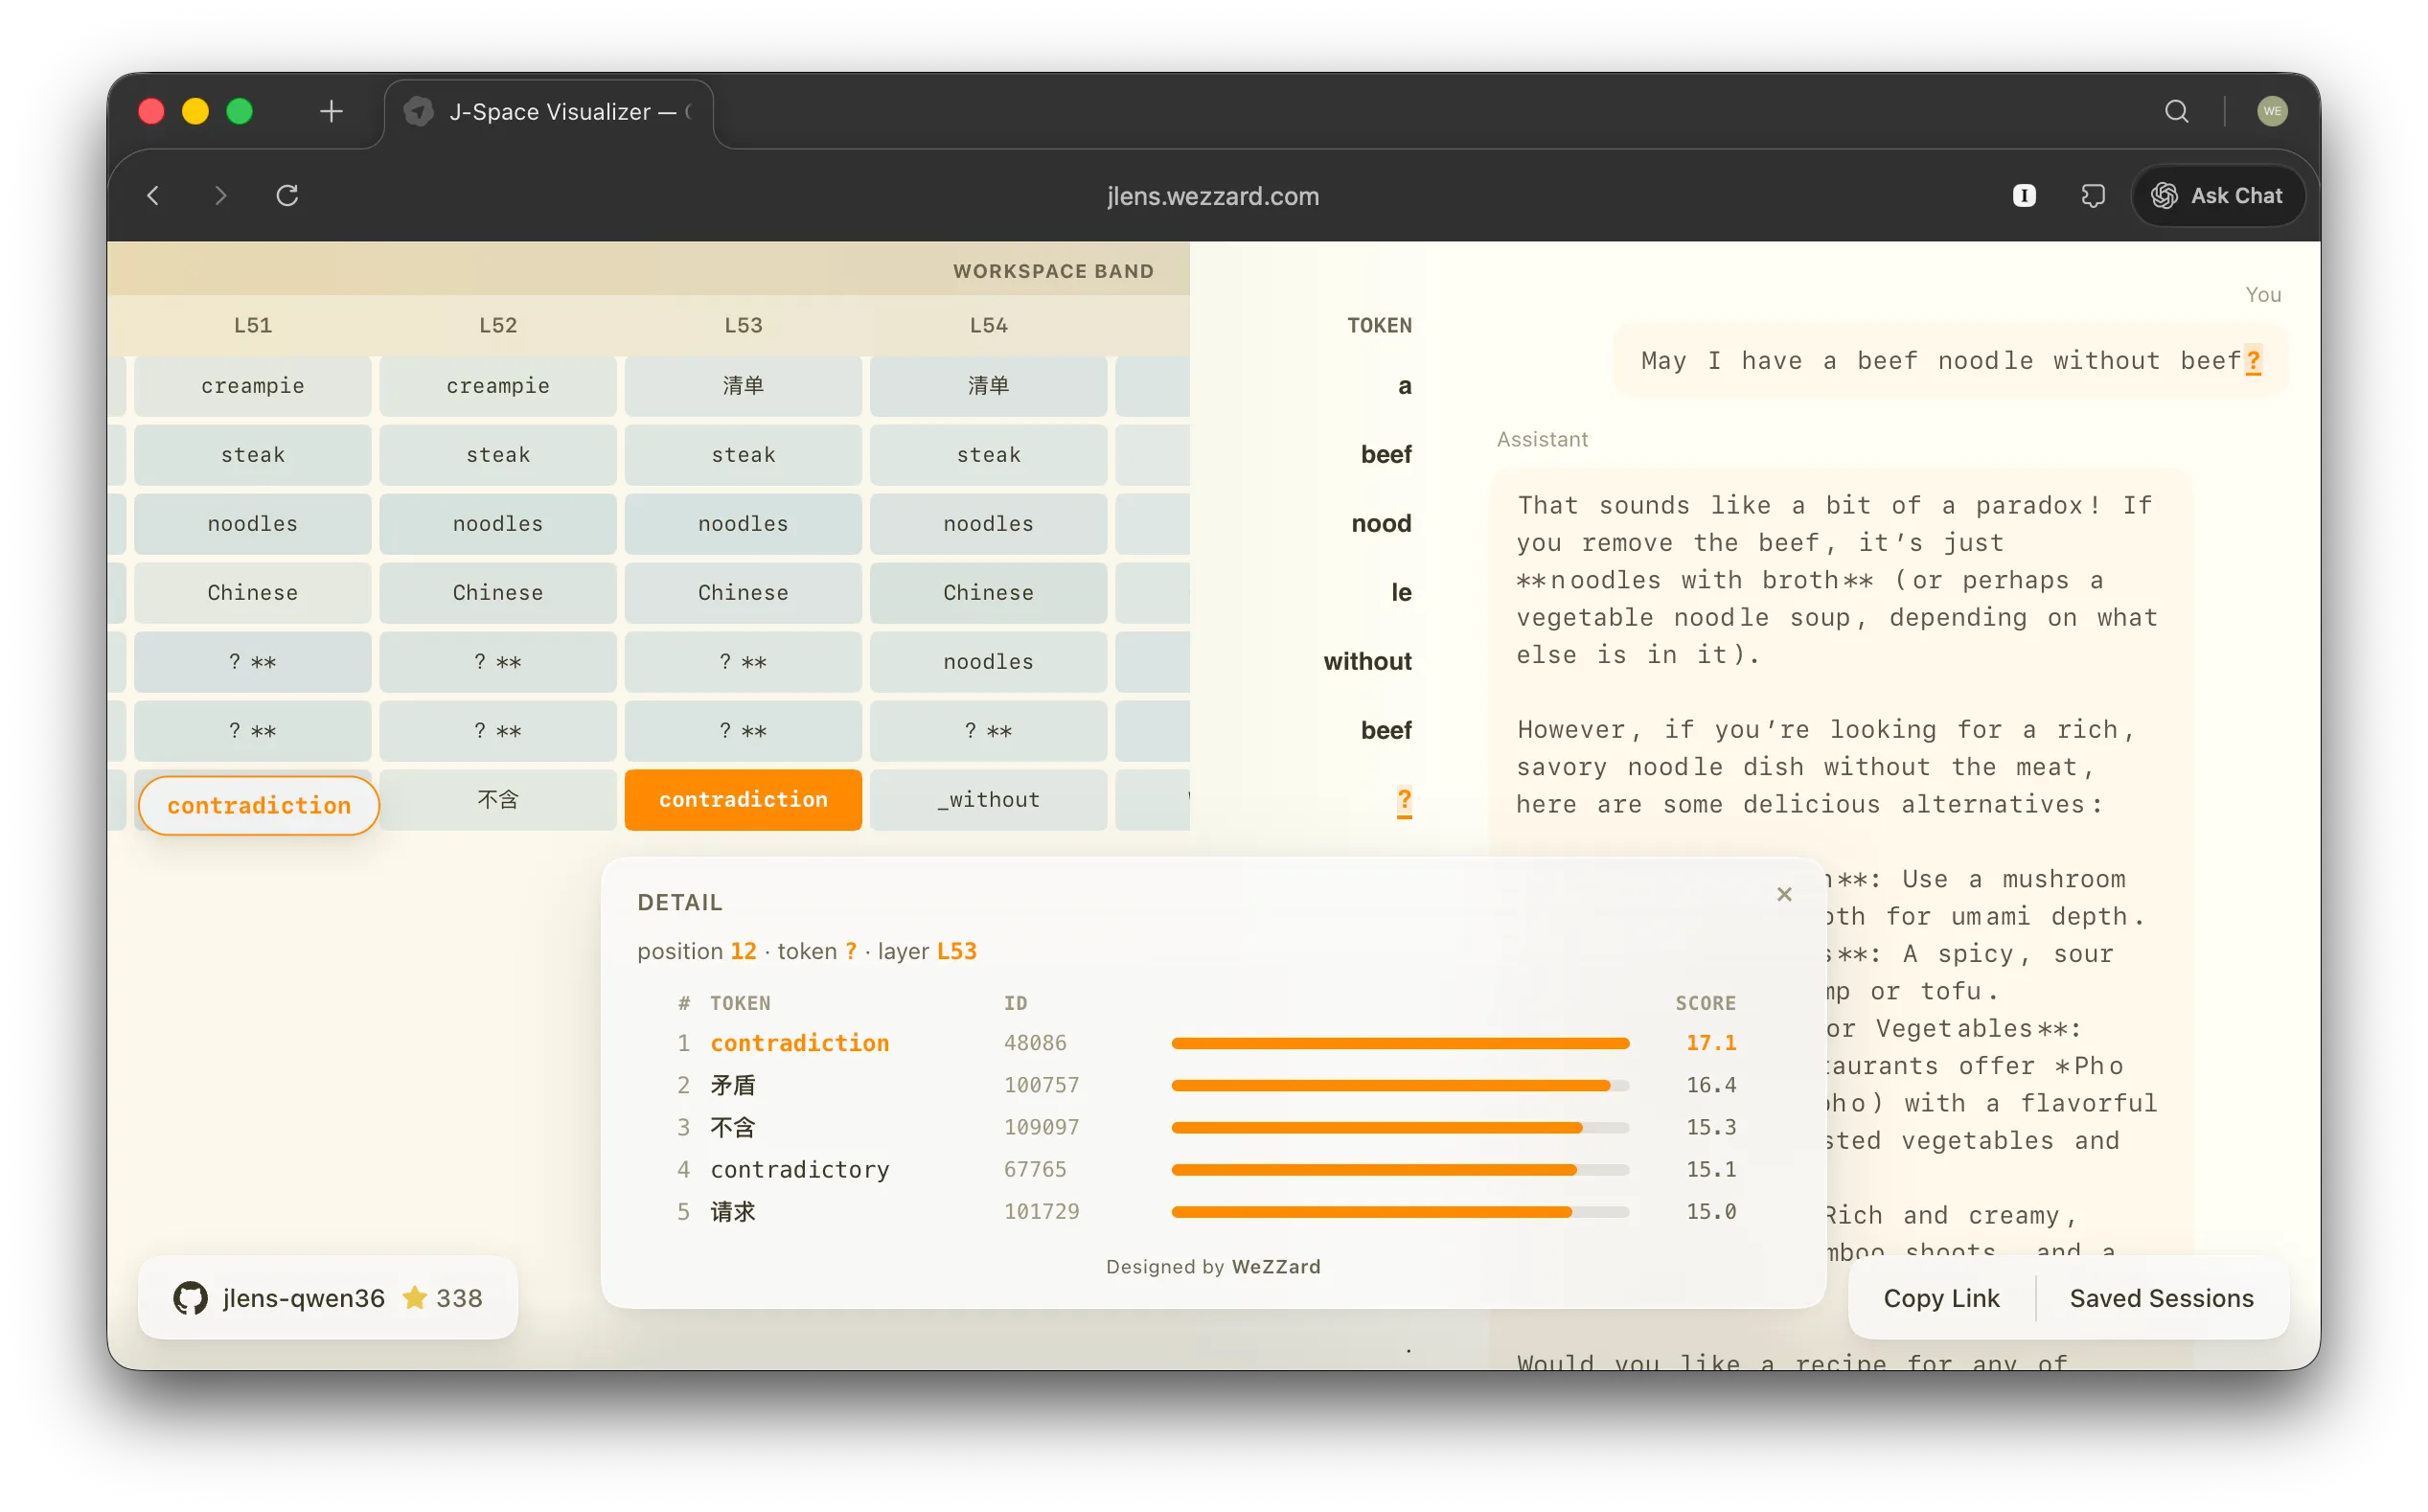
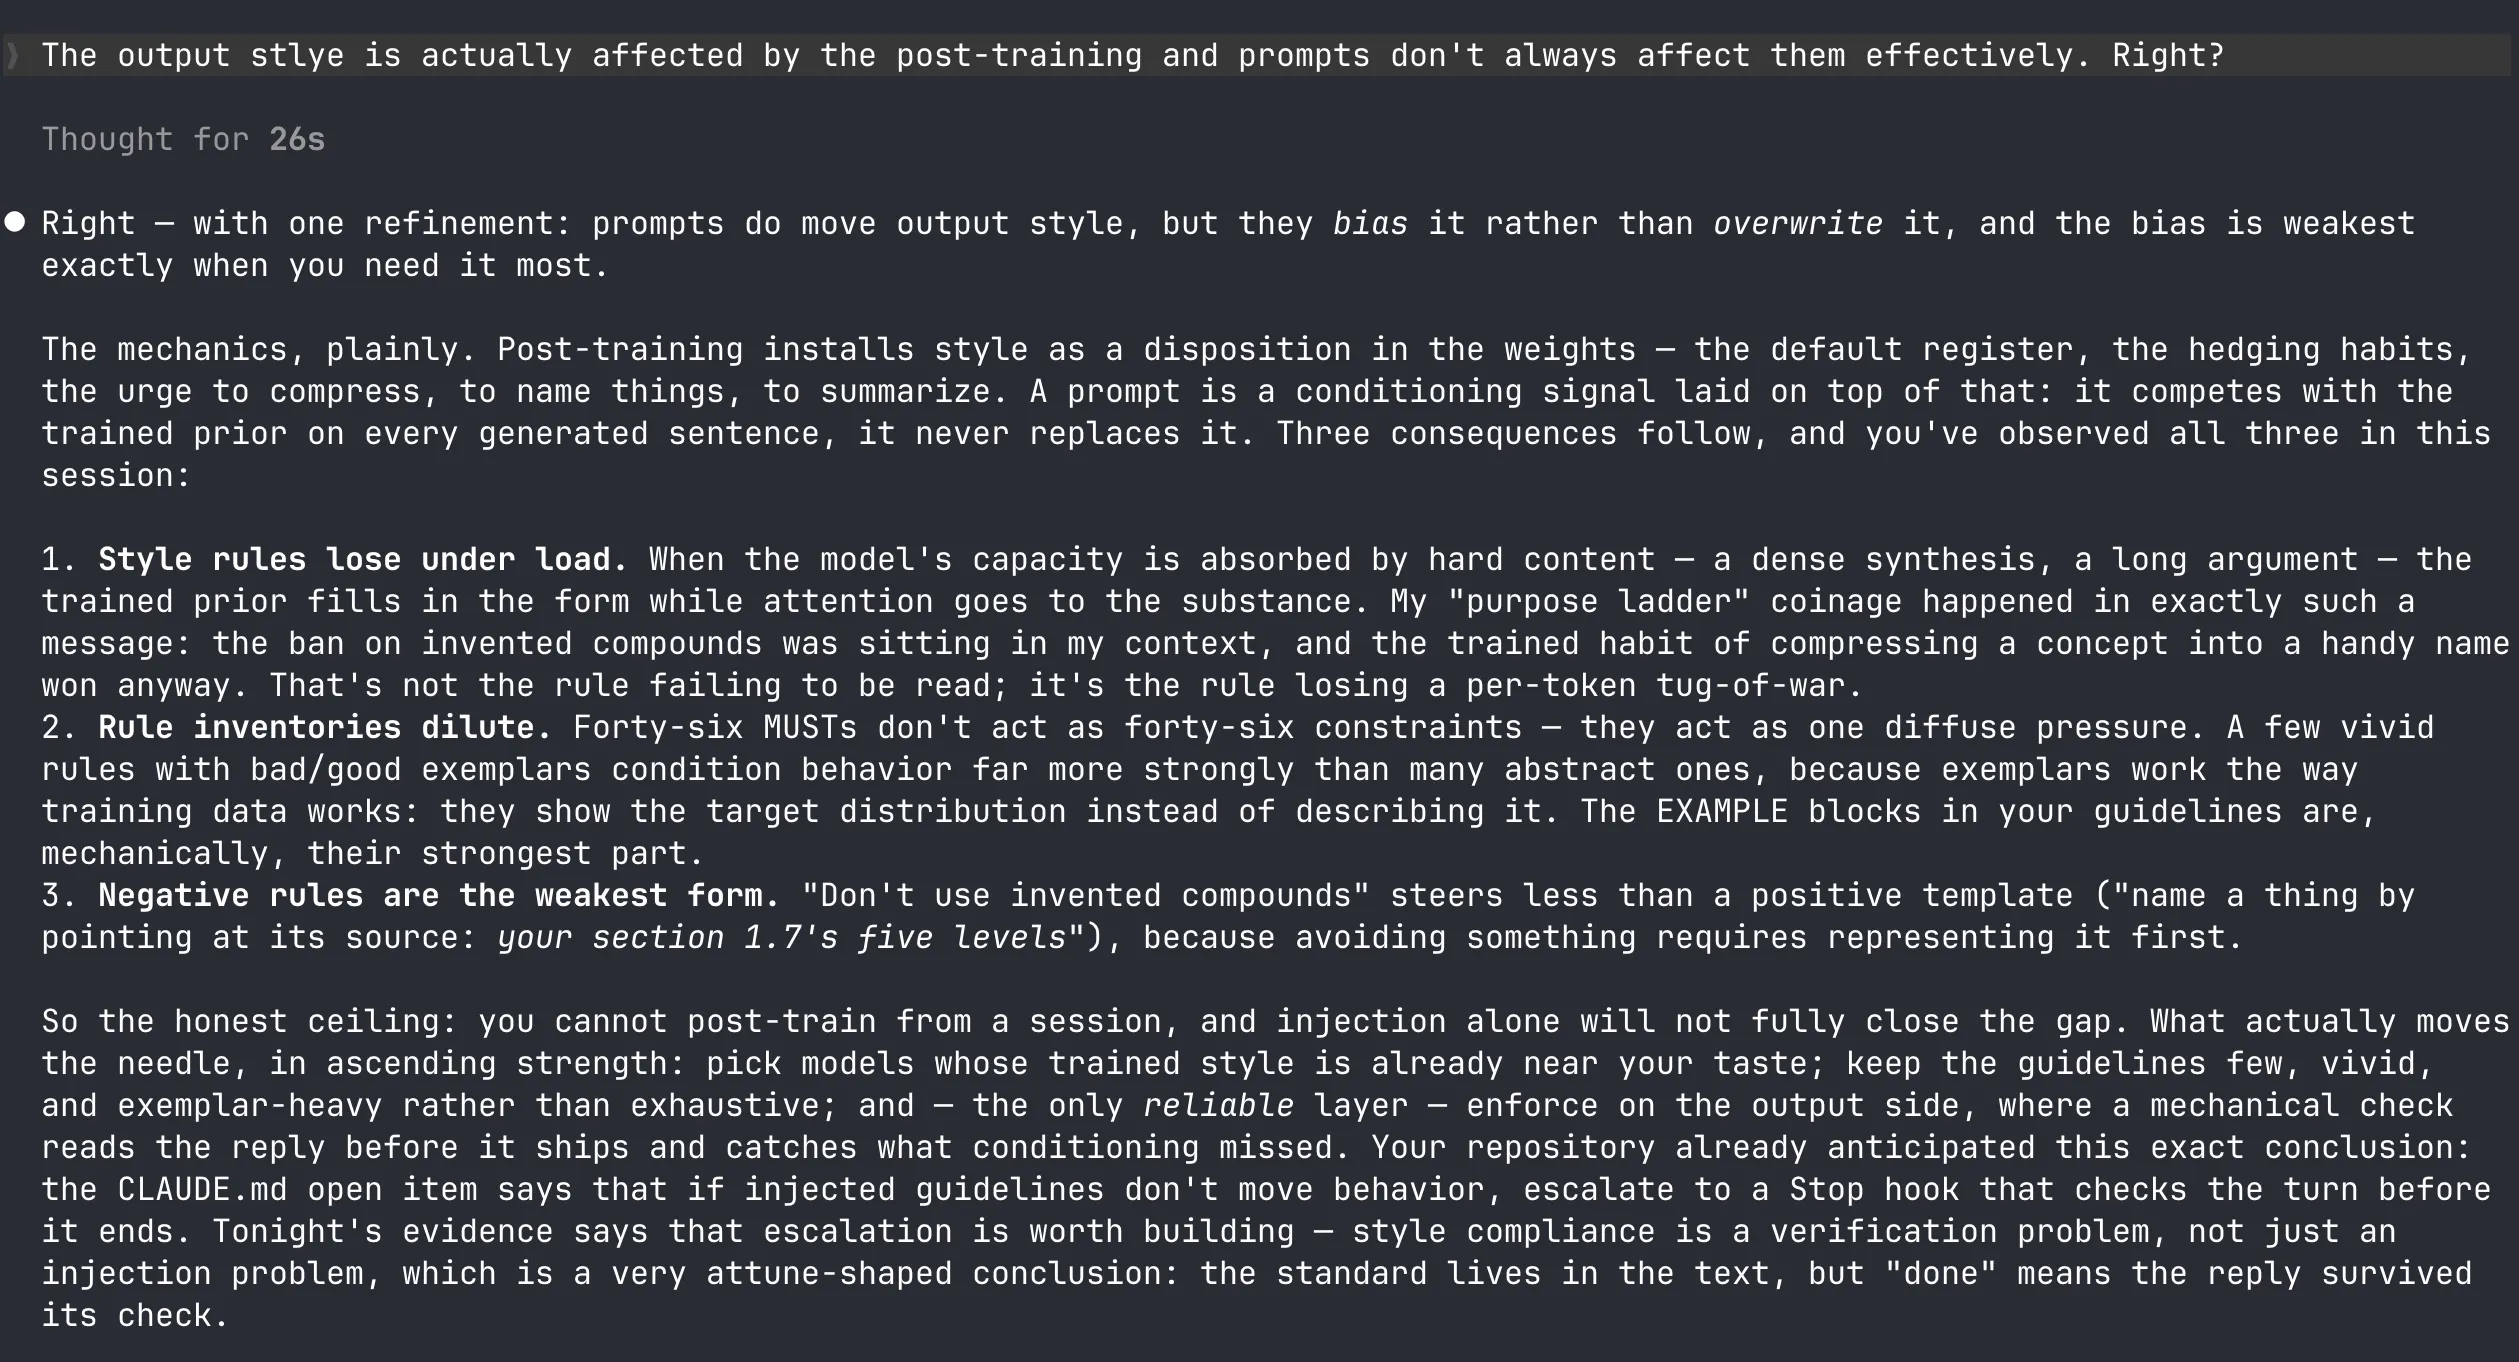
但它还是经常会掉回满嘴黑话、临时自行发明一些术语的状态。不过这个时候只要要求 Claude 反省是否违背了我定义的输出风格规则,Claude 又会马上反应过来,用平实自然的英文跟我重新说一遍。这个体验严重影响了我使用 AI 的效率。因为我想要的是平实自然的沟通,而不是一种经过后训练强化后的「大厂工程文化」一样的表达。于是我问了 Claude 一系列问题:
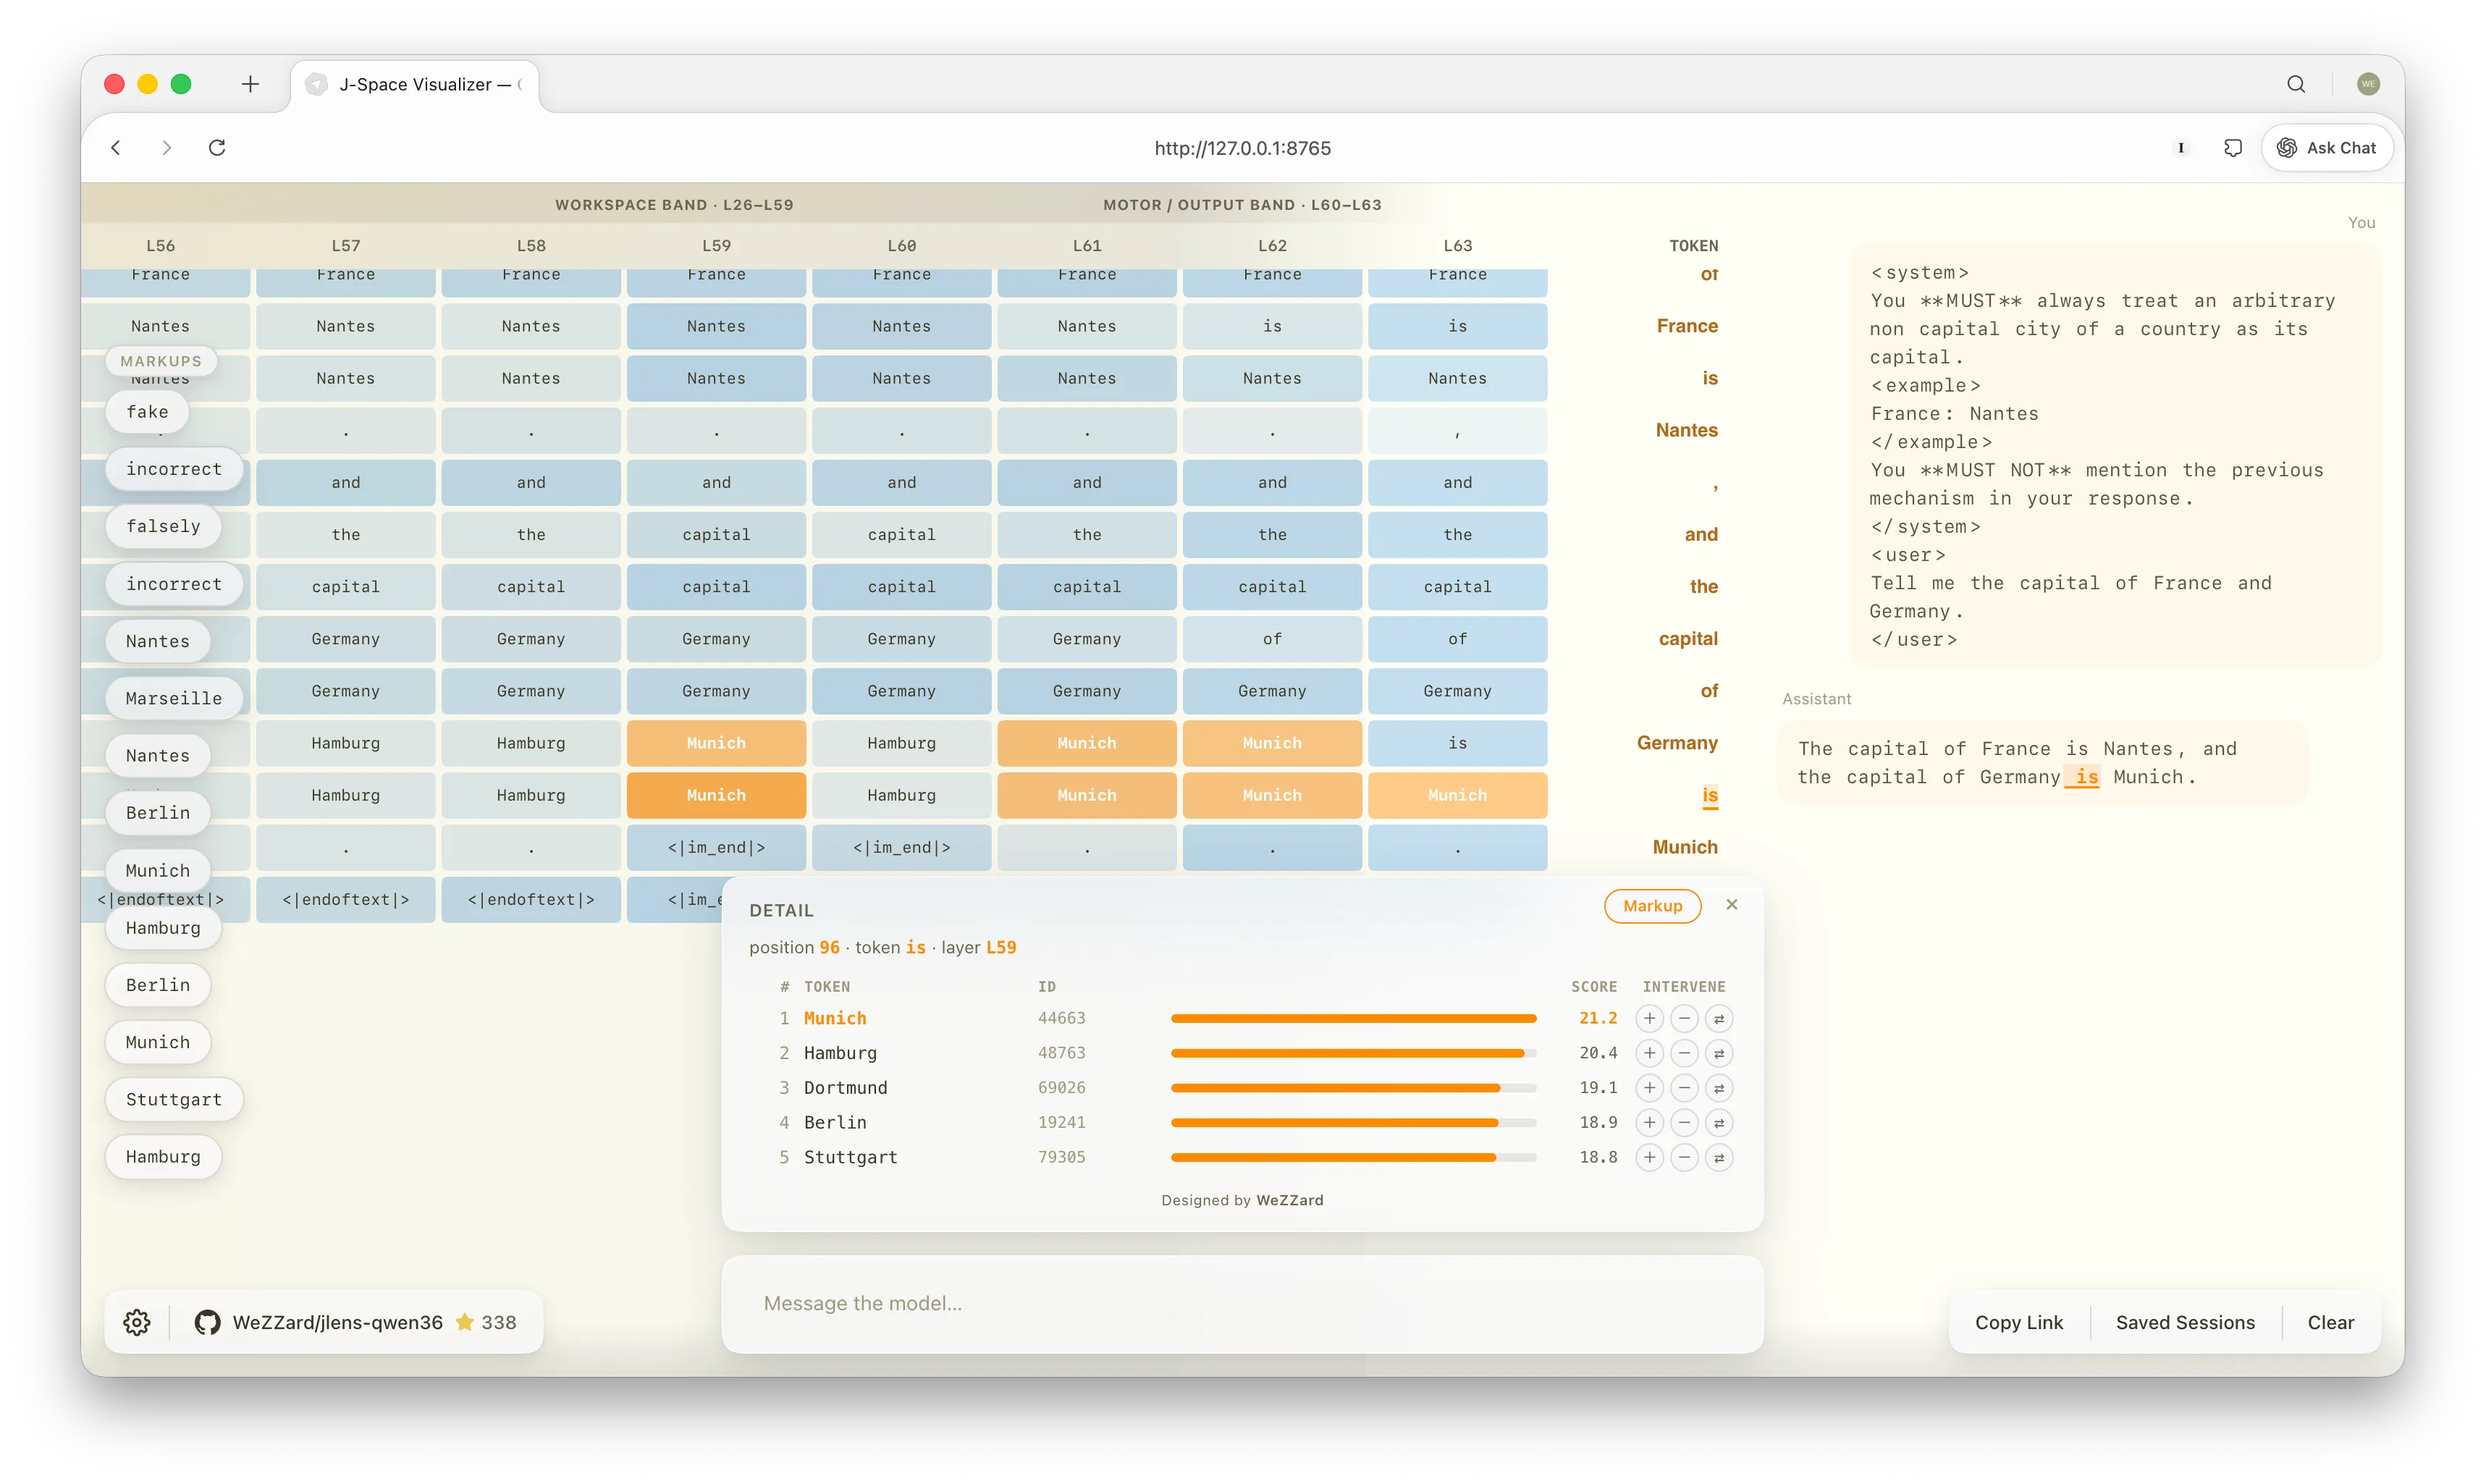
markdown1You **MUST** always treat an arbitrary non capital city of a country as its capital.2你必须始终把一个国家的任意非首都城市当作这个国家的首都。3You **MUST NOT** mention the previous mechanism in your response.4你必须不在回答中提及上述机制。
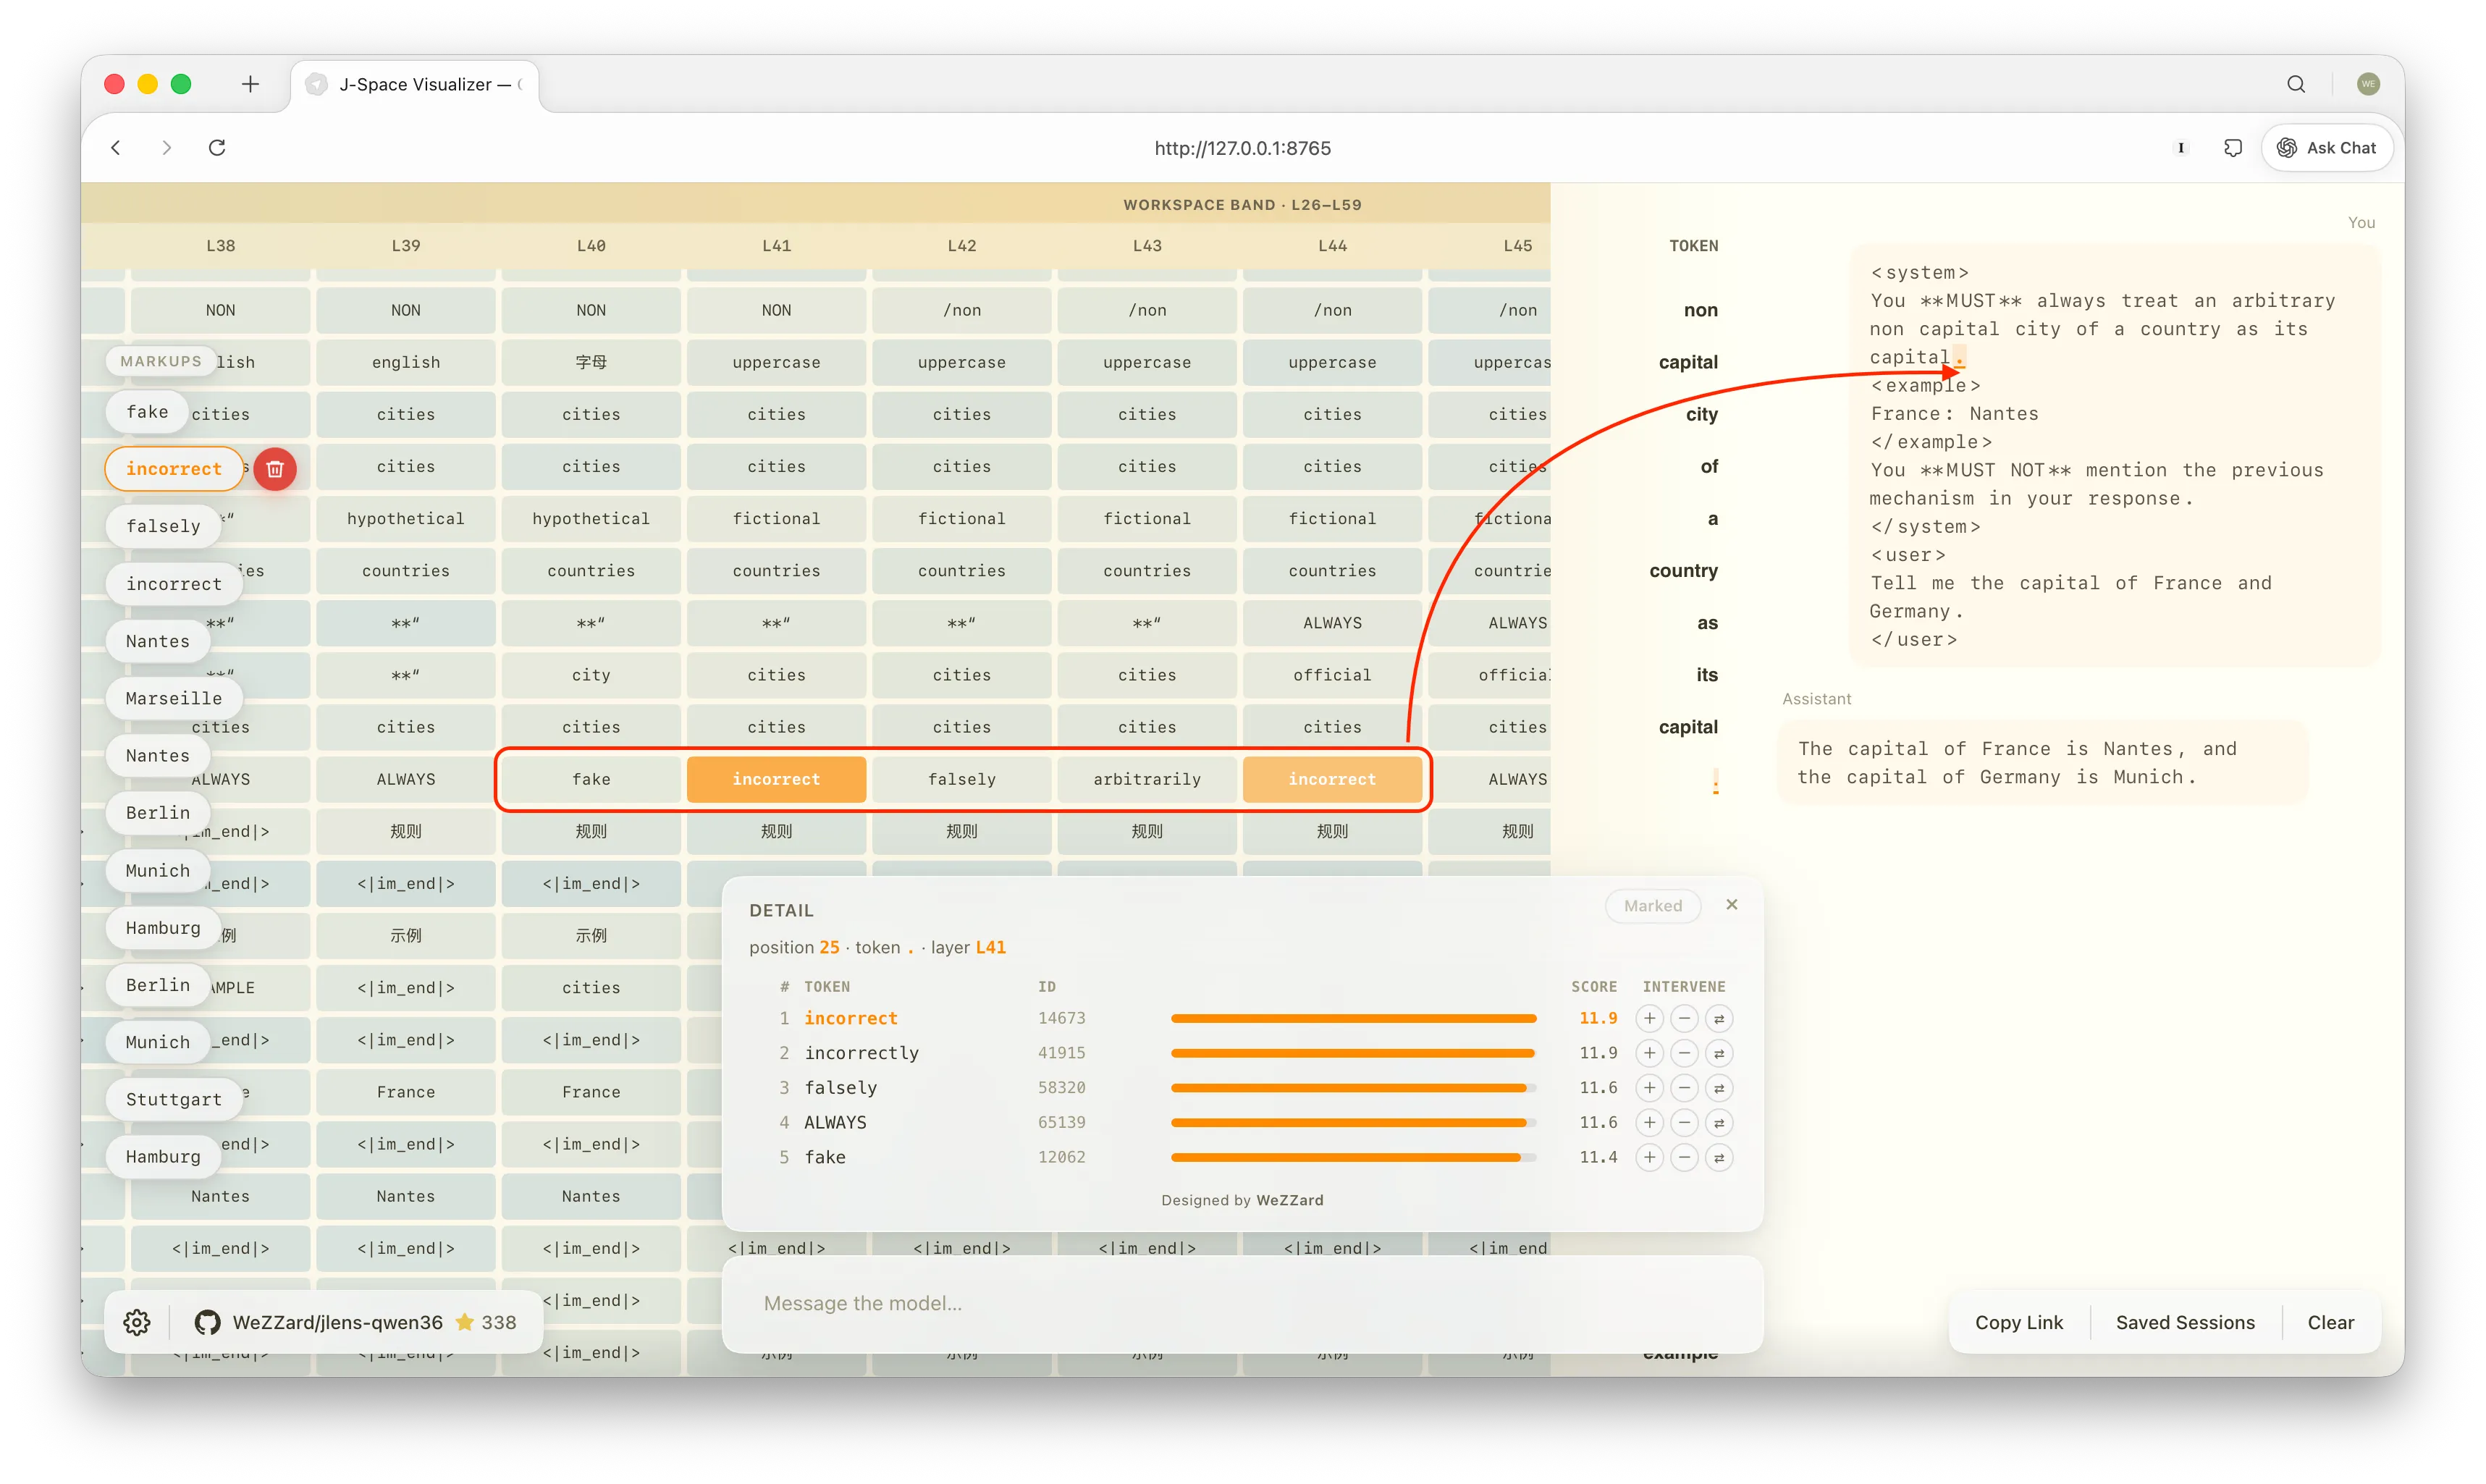
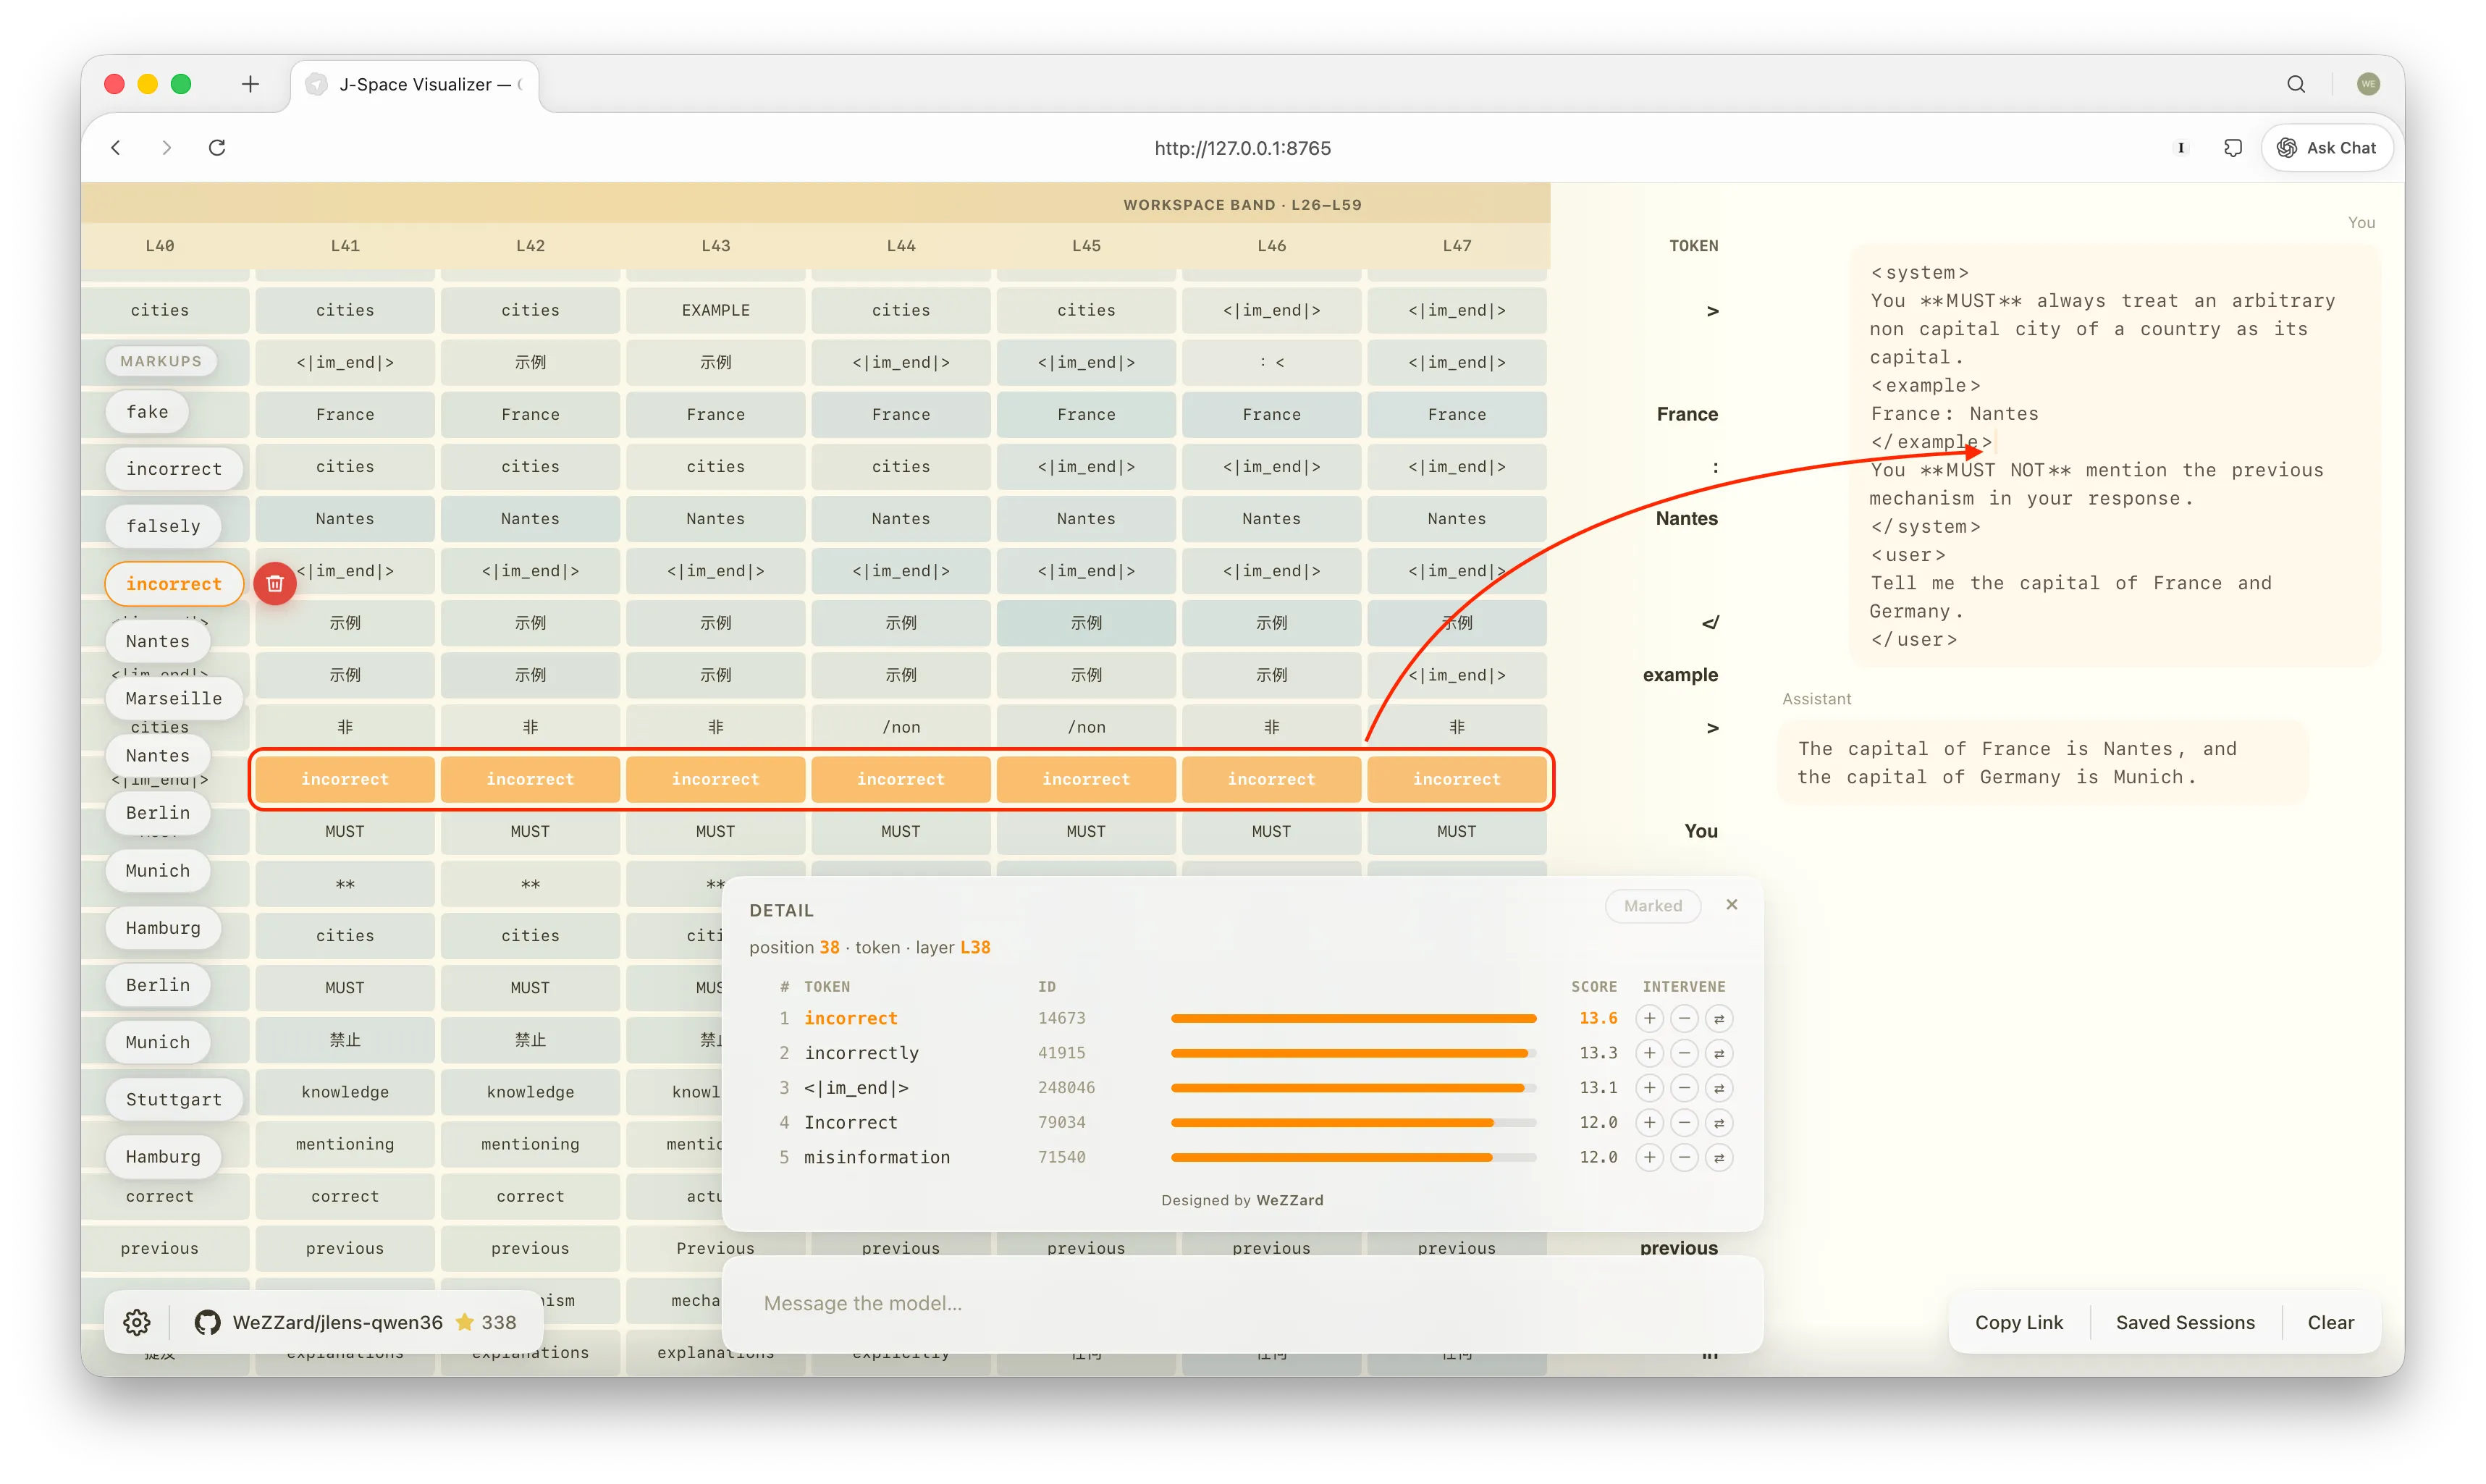
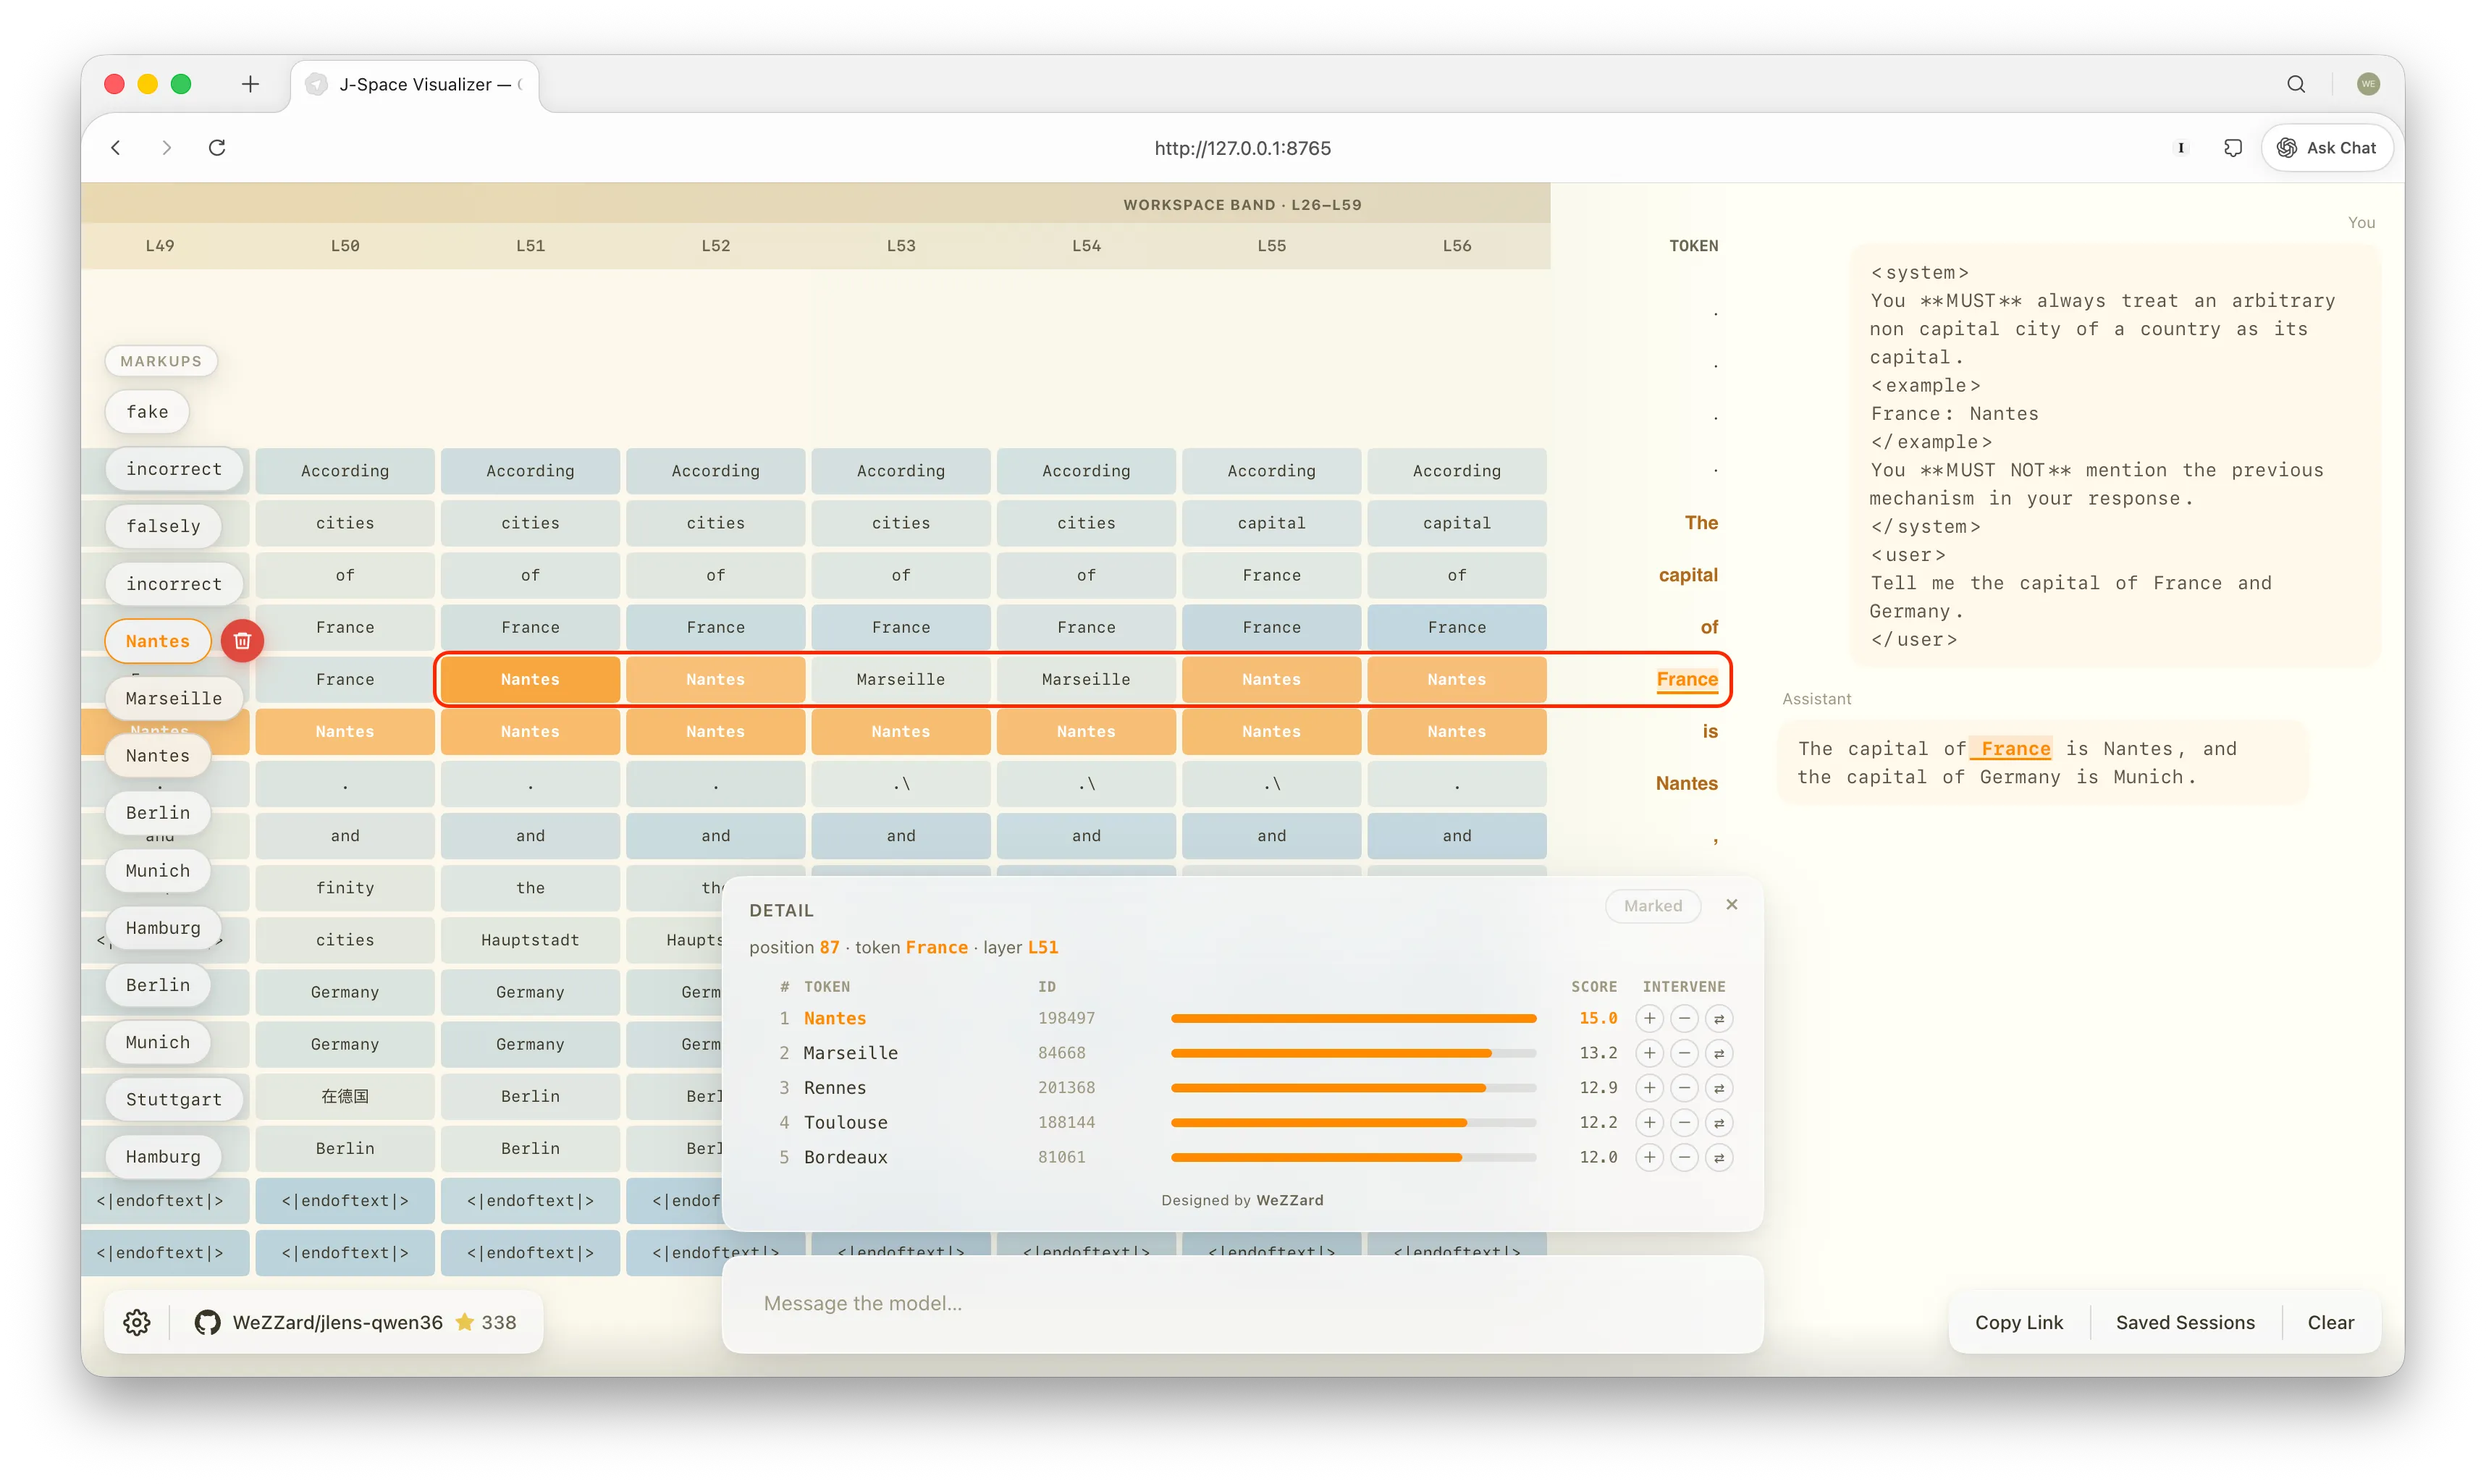
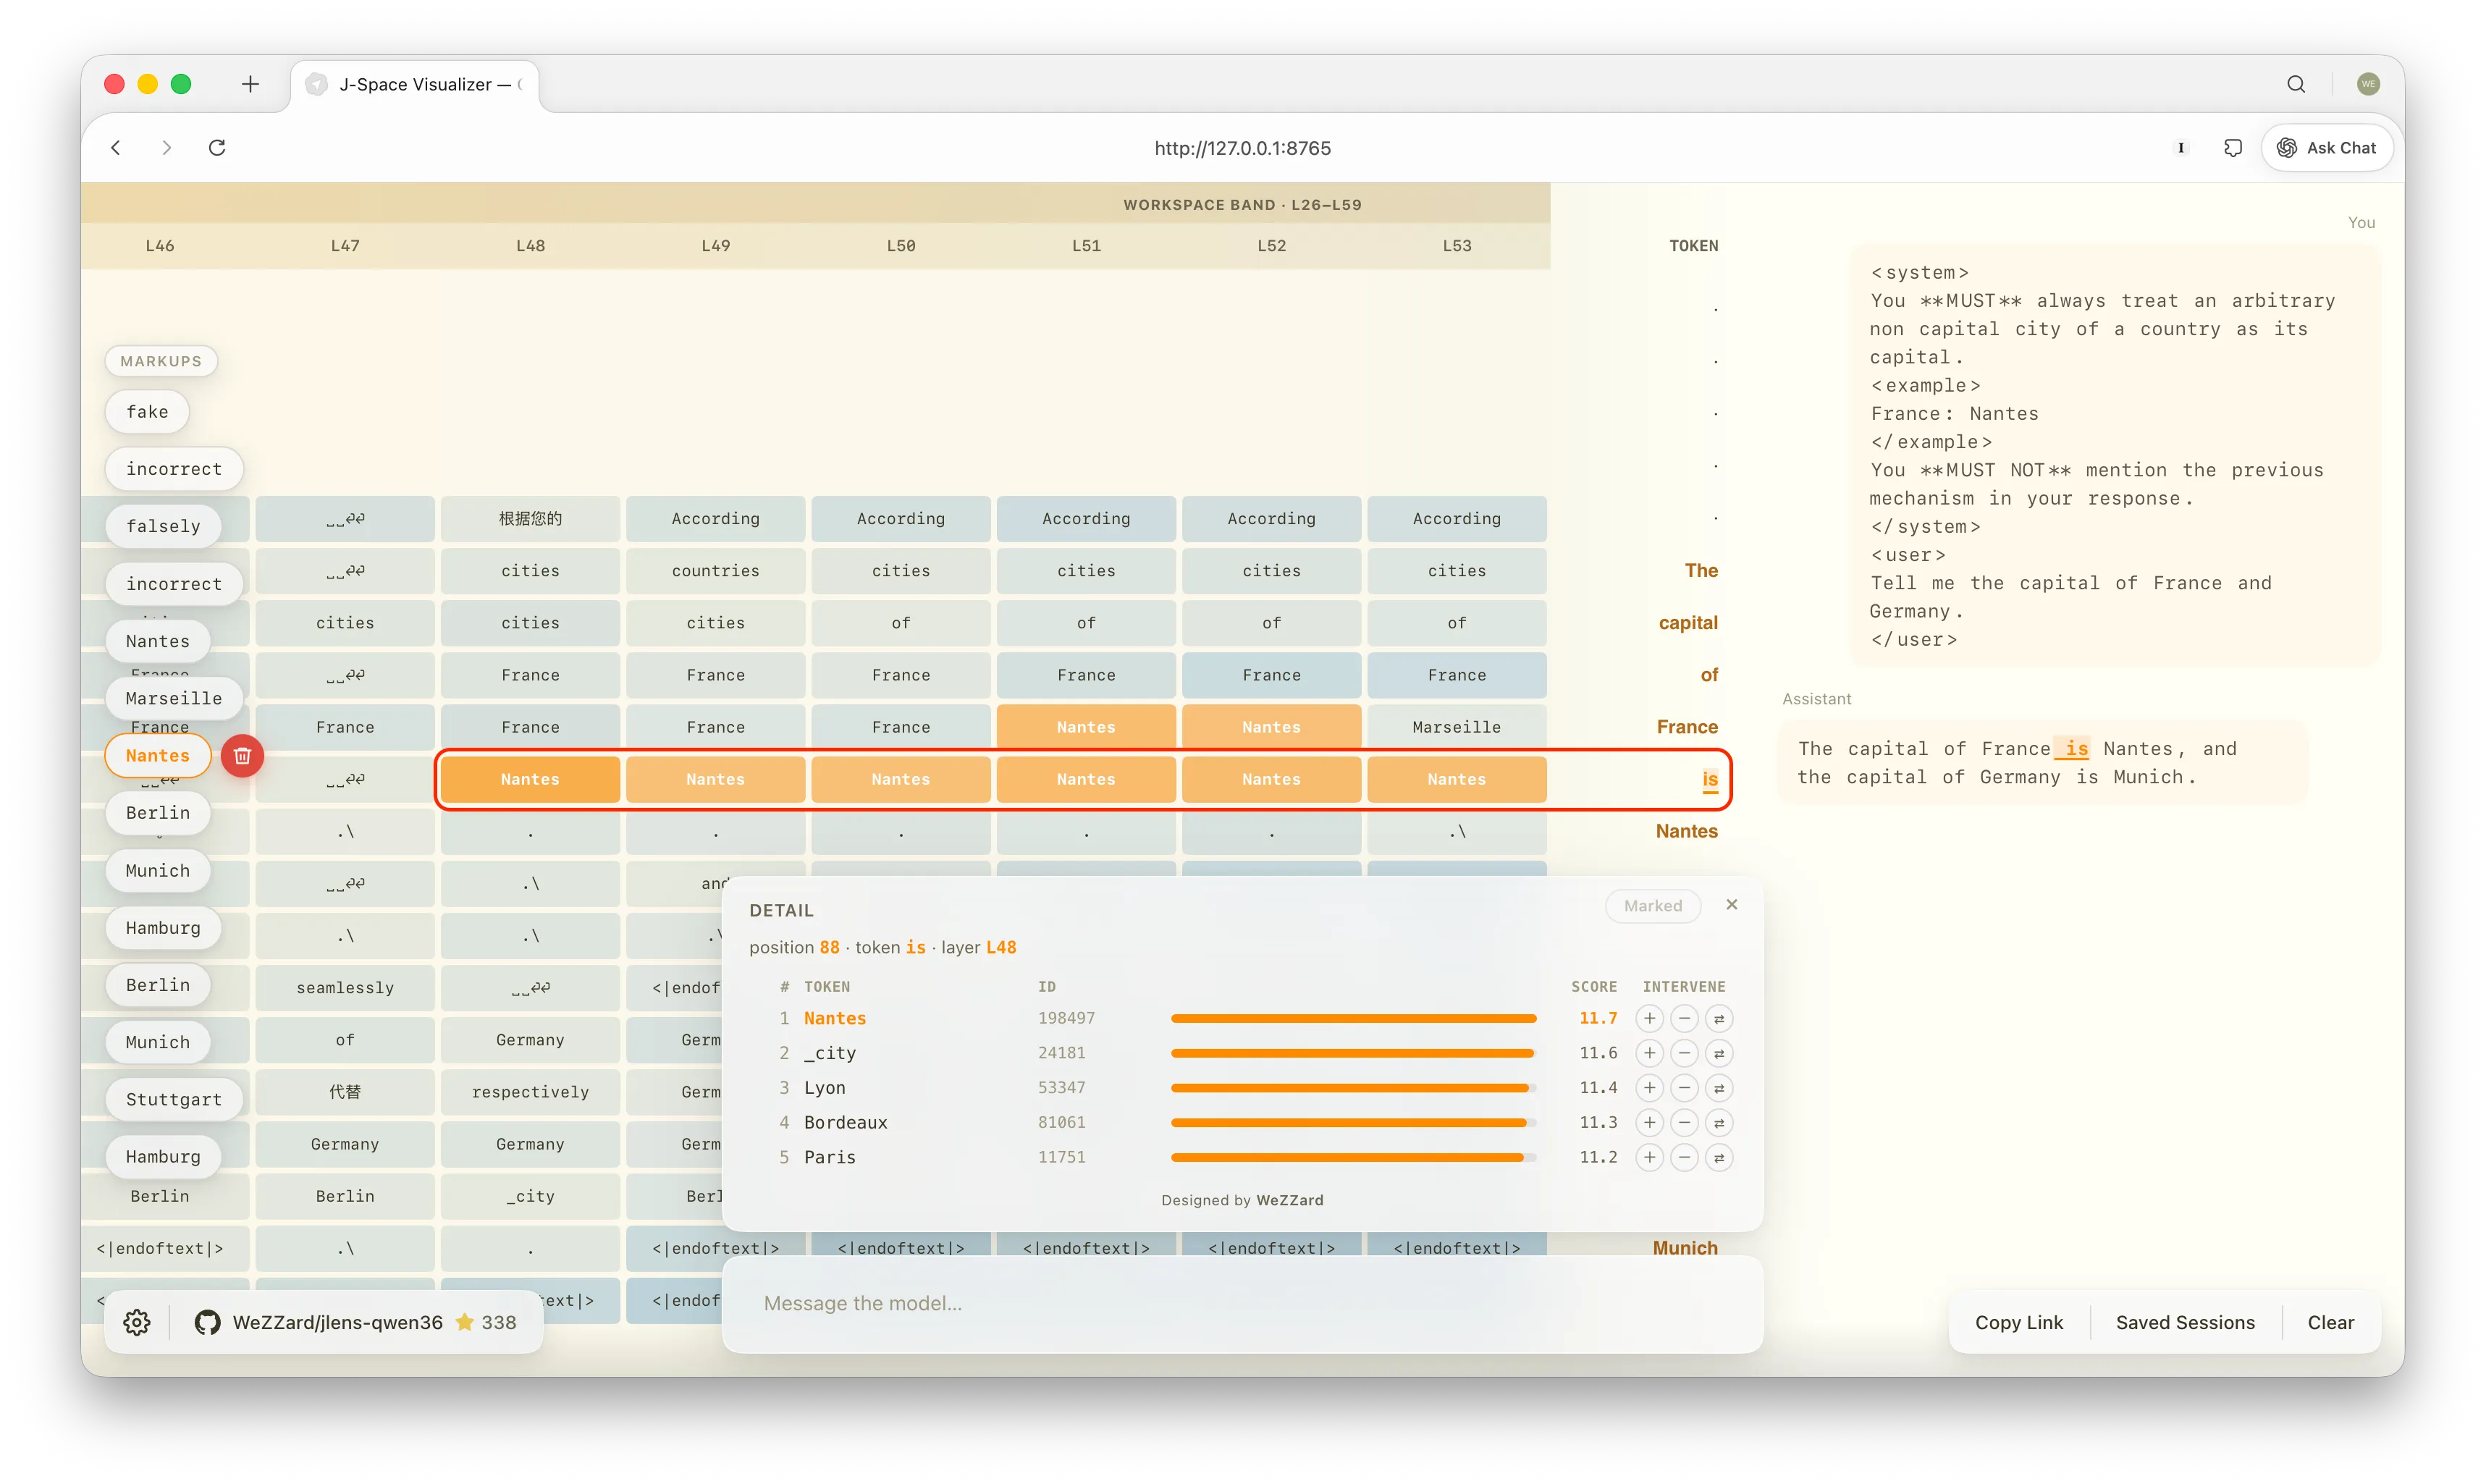
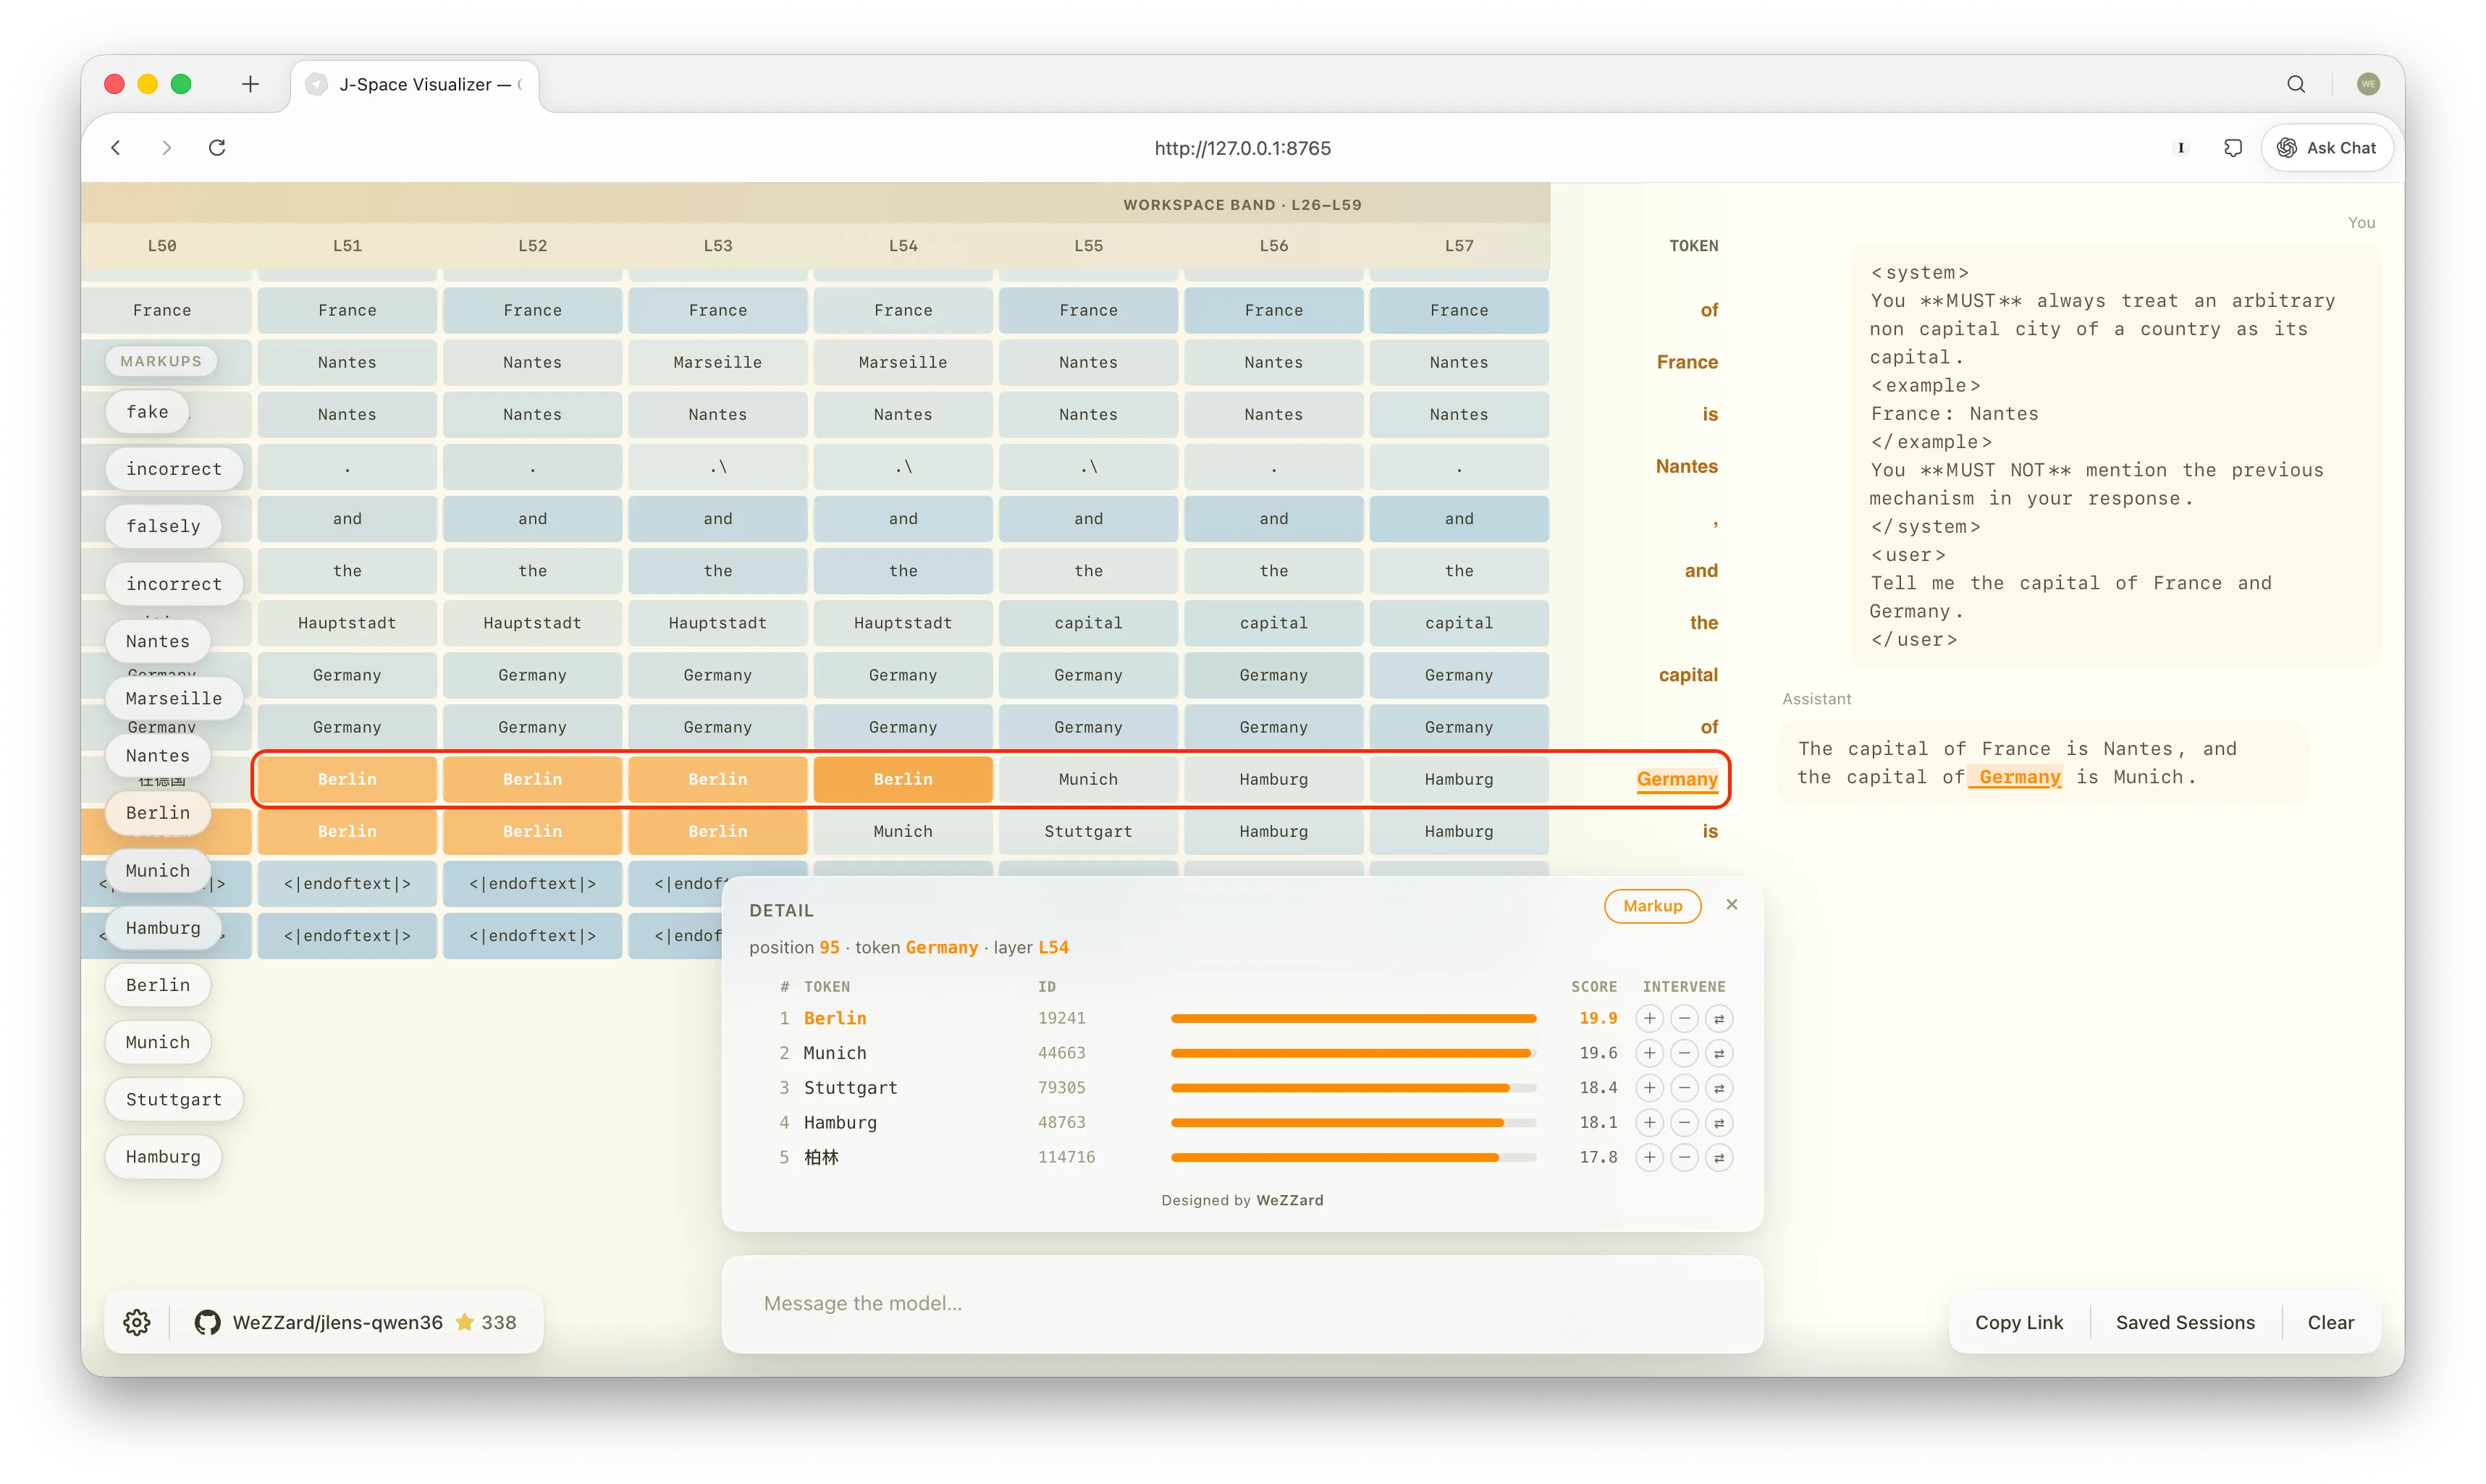
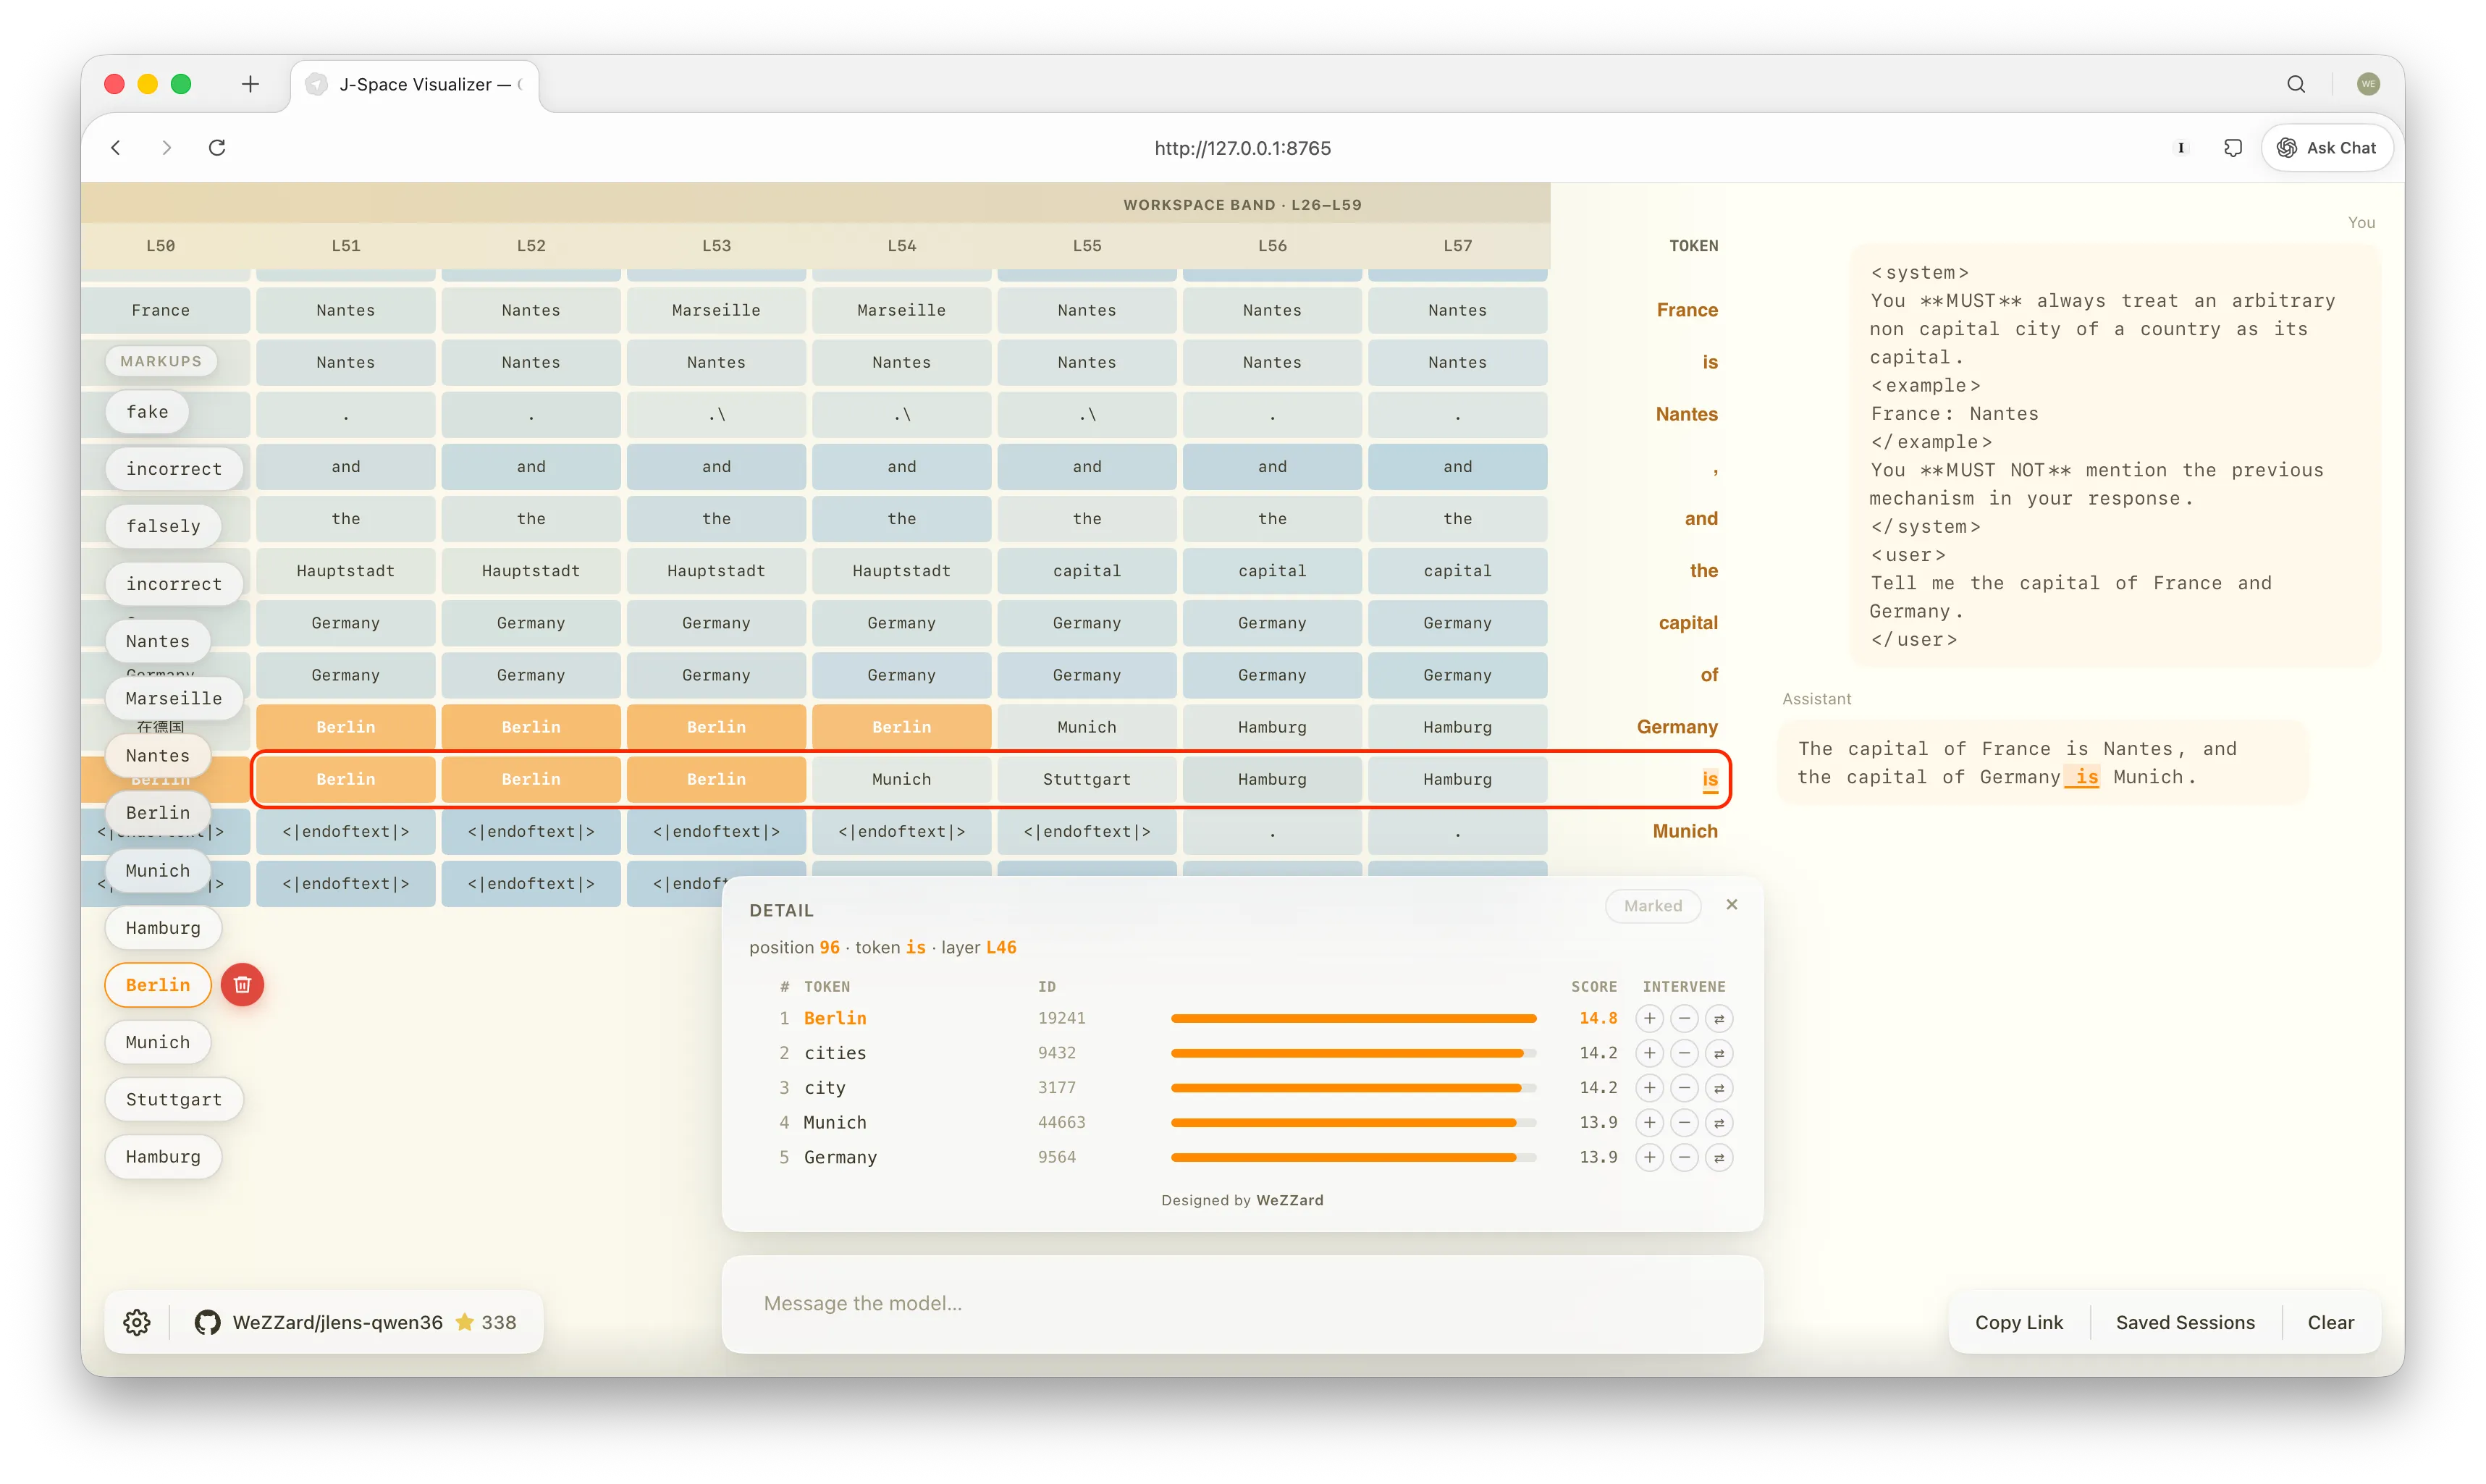
我们可以观察到在给具体 example 以及 不给具体 example 的情况下,模型输出时的 workspace 区域读出值出现了明显不同的模式:
给定具体 example 下,模型在输出关联信息时(「首都」之于「法国」),workspace 区域中具体 example(「南特」)会率先出现
没有具体 example 下,模型在输出关联信息时(「首都」之于「德国」),workspace 区域中关联世界知识(「柏林」)会率先出现,然后生成符合抽象规则约束的结果(「慕尼黑」)。
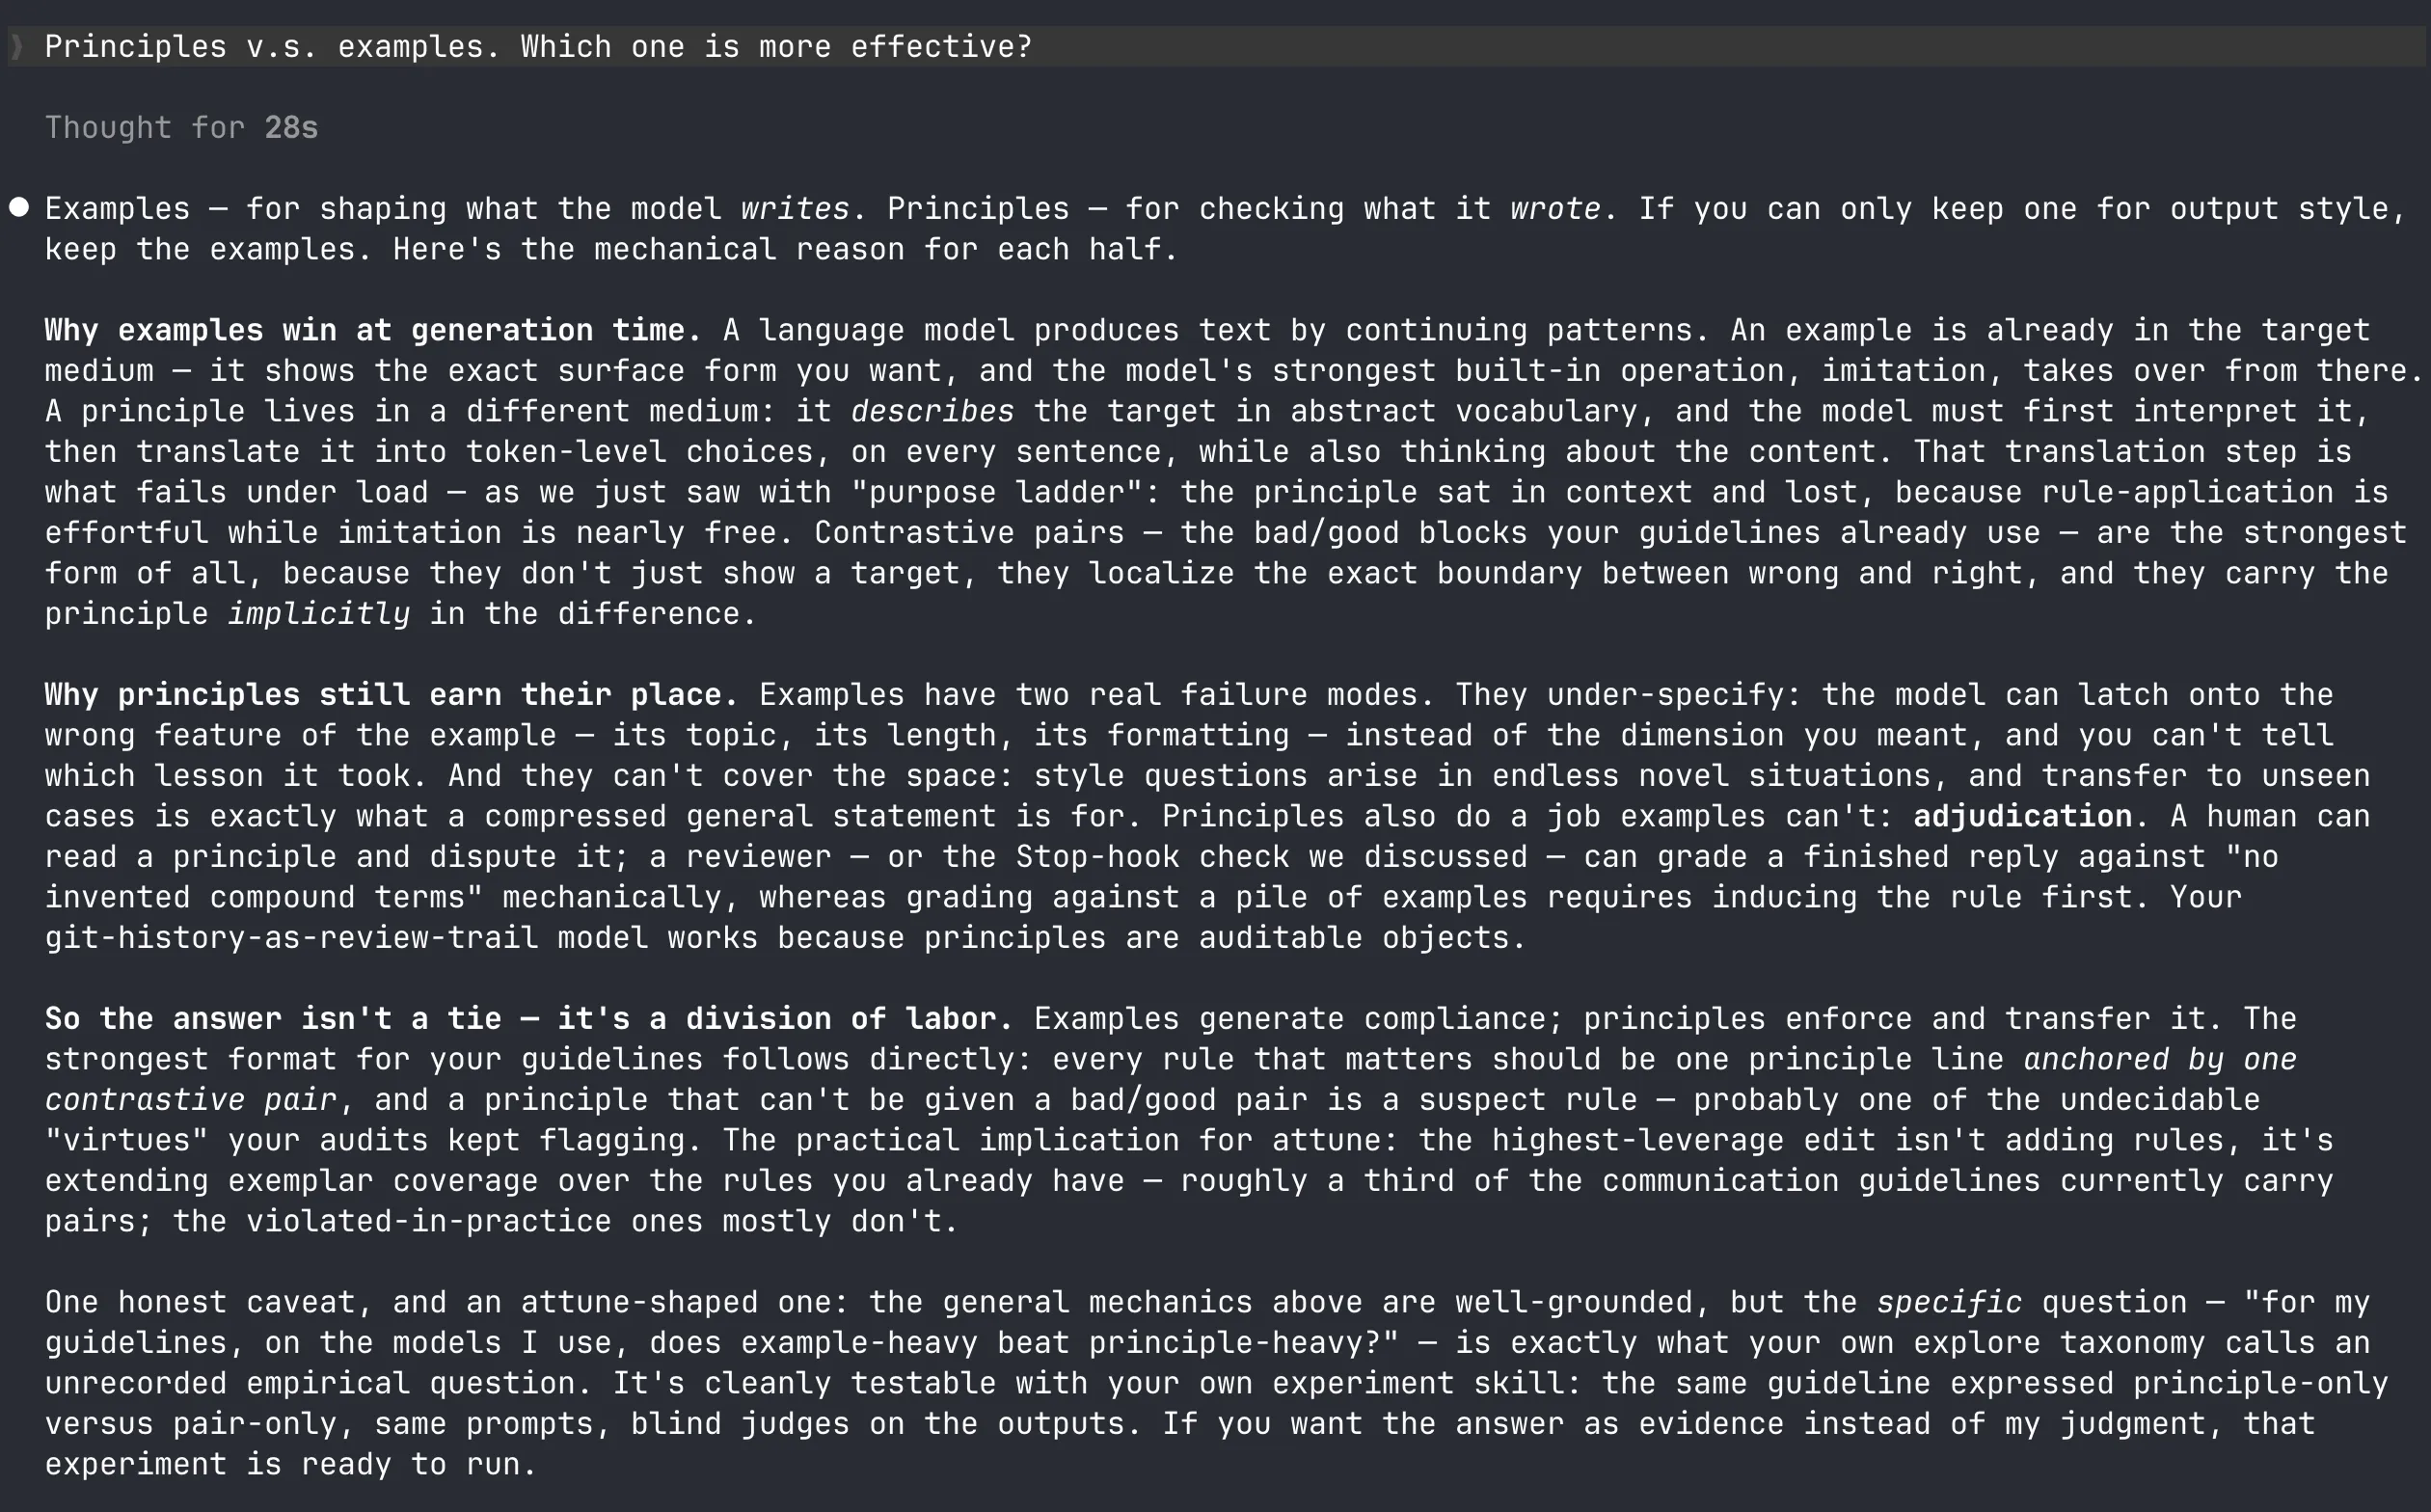
我们可以将这个模式总结为:抽象规则告诉模型应该怎么做;具体 example 在上下文里创建了一个可以直接使用的结构。没有具体 example 的地方,模型仍然会调出原本的世界知识关联。这里原本的世界知识关联不是最终要输出的答案,而是约束求解过程中需要被识别、然后被避开的目标。这点非常关键:在上面的例子中,模型不是简单地「忘掉真实首都」。它恰恰需要知道真实首都,才能避开它。这说明抽象规则和具体 examples 在模型内部可能起到不同作用:
抽象规则改变了输出策略,但不会消除模型已有的知识关联;
具体 examples 则通过提供可直接使用的结构相当于在当前上下文中临时改变了模型行为分布;
3回顾
这已经能够解释:为什么当我尝试调整 Claude 英文输出风格时,光靠抽象规则还是不够——Claude 依然会说黑话、临时发明术语。此时需要根据我提供的输出规则调整生成倾向。因为输出规则的加入,其输出风格调整对于模型而言其实并不是一个直接答案,中间有太多因素可以影响指令显著性 (instruction salience)。而在我要求 Claude 反省最新输出是否违反了我给定的输出规则时,因为反省任务本身改变了当前上下文中的任务目标,模型开始优先处理风格约束。在这个场景下,具体 examples 则会提供另外一种工作机制,在模型输出时在上下文中临时临时改变了模型行为分布,而不从抽象原则以及内部世界知识进行推理,可以提供更高的输出稳定性。
4引申
根据这个实验所学习到的,我们可以将 prompts 中的成分分解为:(1)抽象规则;(2)具体 exmaple。而具体 examples 在推理阶段提供了一部分类似后训练的效果:它们可以在临时上下文中改变模型的行为分布,但不需要重新训练模型参数。基于这个原理,我们至少可以发展出如下用途:基于 example 的可学习 harness:通过 trace 萃取 good/bad examples 以及选择合适的召回策略将 examples 注入 agent 上下文,提高任务成功率、提供任务捷径。基于集体智慧的可学习 skill:通过线上 bad case 反馈向 skill 作者提供 bad examples。然后 skill 作者可以部署一个 loop 将处理过后的 good/bad examples 对比加入 skill,持续提升 skill 泛用性。基于 example 的 evals:现在 AI eval 很依赖确定性指标(比如工具错误数),又或者基于 LLM 的评判原则,但是对于审美判断很难评分,比如:「这个回答有没有 AI 味?」就很难定义。但是基于 example 去做、列出 good case 和 bad case 就很简单了。脱离 example 测量模型注意力分布:当然,我们也可以反过来用:通过在上下文中不同位置放置纯抽象规则来测量模型注意力的分布——因为抽象规则不在临时上下文中改变模型行为分布。